Ouvrir le capot de l’IA
Architecture de référence d’une IA d’entreprise
Introduction — Passer d’une collection de briques à un système
Marie : L’assistant Bikaroo doit consulter les procédures, vérifier l’état d’un trajet, utiliser les données Semi-Pro League, demander une confirmation avant une action et conserver une trace. Où place-t-on toutes ces responsabilités ?
Architecte Bikaroo : Pas dans le LLM. Elles sont réparties entre l’expérience utilisateur, l’orchestrateur, les couches de connaissances et de capacités, les systèmes métier et les contrôles transverses.
Les chapitres précédents ont introduit séparément le LLM, les embeddings, le RAG, les outils, MCP, l’orchestration, les agents, la mémoire, la sécurité et l’observabilité. Une solution d’entreprise ne juxtapose pas ces composants au hasard : elle attribue à chacun une responsabilité claire et limite les dépendances inutiles.
Ce chapitre rassemble les briques dans une architecture de référence. Celle-ci ne constitue pas un produit universel à recopier, mais un cadre permettant de raisonner sur les flux, les frontières de confiance, les sources de vérité, les plans de contrôle et d’exécution, ainsi que le cycle de vie de la solution.
Ce que vous allez apprendre
À la fin de ce chapitre, vous pourrez :
- lire une architecture fonctionnelle d’IA d’entreprise et expliquer le rôle de ses couches ;
- distinguer expérience utilisateur, plan de contrôle, capacités d’IA et systèmes métier ;
- positionner RAG, tools, MCP, mémoire, modèles spécialisés et stockage d’artefacts ;
- comparer des options de déploiement locales, cloud et hybrides ;
- définir une architecture minimale viable et une trajectoire de maturité adaptée au besoin.
Lire l’architecture fonctionnelle
Cette architecture de référence doit être lue comme une carte, pas comme un plan de construction unique. Son rôle est de montrer où se placent les responsabilités : expérience utilisateur, orchestration, connaissances, capacités d’action, systèmes métier et contrôles transverses.
Vous pouvez ensuite adapter cette carte à votre contexte : assistant documentaire simple, assistant connecté, agent contrôlé ou plateforme plus complète.
Vue fonctionnelle
Utilisateur
 ↓
Canal
 ↓
Application IA
 ↓
Orchestrateur
 ┌──────────┬──────────┬──────────┬──────────┬──────────────┐
 ↓          ↓          ↓          ↓          ↓              ↓
LLM        RAG      Mémoire    Tools     Workflow   Modèles spécialisés
 ↓                    ↓          ↓
 Base vectorielle  API / MCP / SI  Image / audio / vidéo
 ↓
 Stockage d'artefacts
Autour :
identité
sécurité
politiques
validation
observabilité
audit
coûts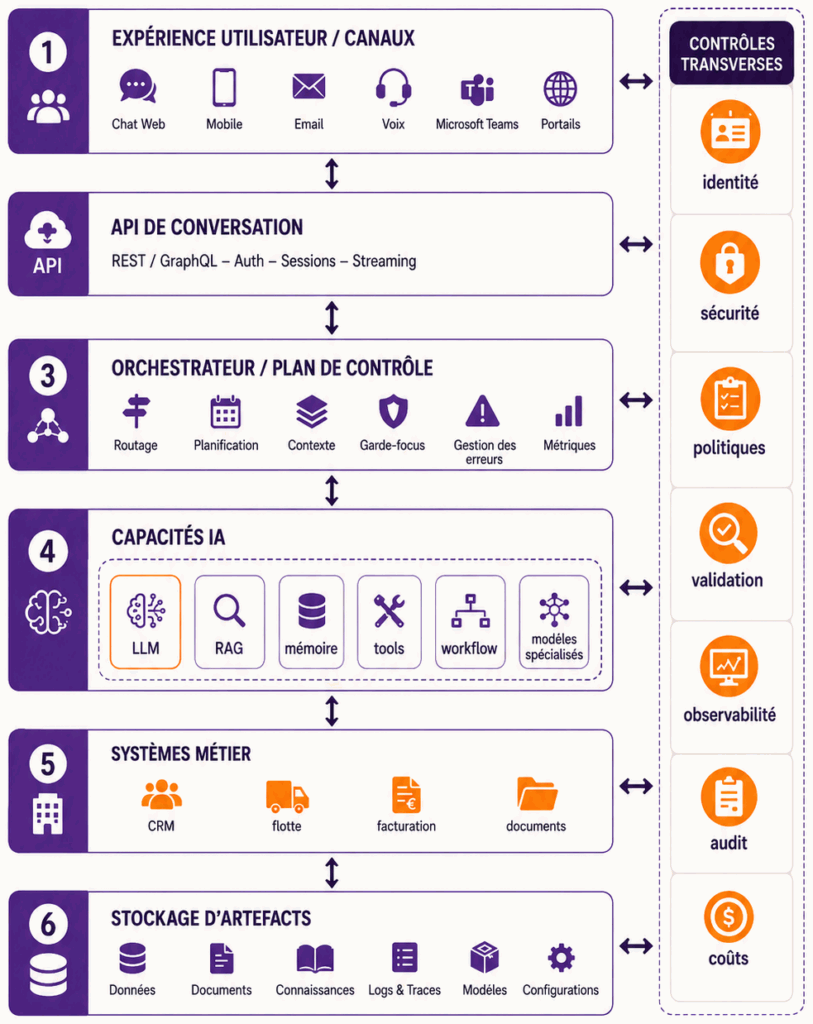
Canaux
Les points d’entrée sont nombreux et hétérogènes — web, mobile, Teams, e-mail, CRM, portail, API, voix. Ce qui compte n’est pas leur liste, mais leur finesse : un canal présente une interface, authentifie, transmet les pièces jointes, diffuse la réponse en flux, recueille les confirmations et affiche les sources.
Il ne devrait pas porter toute la logique agentique.
API de conversation
Une couche API peut normaliser :
messages
sessions
fichiers
identité
streaming
feedback
Elle sépare les canaux de l’orchestrateur.
Cela permet à plusieurs interfaces d’utiliser la même logique.
Orchestrateur
Ses responsabilités se regroupent en trois temps. Il prépare — construit le contexte, sélectionne le modèle, lance le retrieval, expose les tools. Il encadre — tient l’état, applique les workflows, demande les validations, contrôle les budgets. Il rend compte — trace ce qui a été décidé et exécuté.
Il constitue le plan de contrôle.
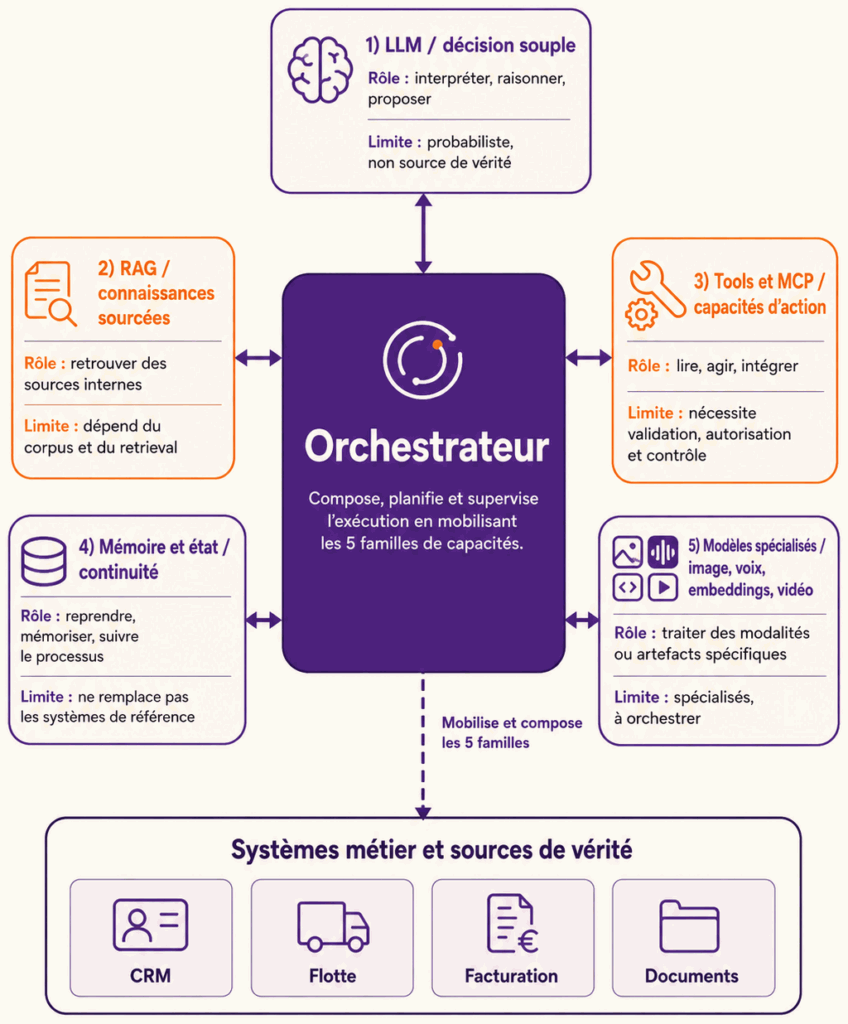
Organiser l’intelligence et les capacités
Une fois l’orchestrateur positionné, il faut distinguer les capacités qu’il peut mobiliser. Certaines relèvent de l’intelligence probabiliste, comme le LLM ou les modèles spécialisés. D’autres relèvent de la connaissance, comme le RAG. D’autres encore relèvent de l’action contrôlée, comme les tools, MCP ou les workflows.
L’architecture devient plus lisible si chaque capacité a un rôle clair et si aucune ne remplace les autres par accident.
Model gateway
Une passerelle de modèles interpose une couche entre l’application et les fournisseurs. Elle apporte trois choses : l’indépendance — abstraction des fournisseurs et routage ; la maîtrise — quotas, versions, fallback et politiques ; l’observation — logs, masquage et mesure des coûts.
Elle évite de coupler l’application à un seul modèle.
Modèles spécialisés
La passerelle ou l’orchestrateur peut router différentes tâches vers :
LLM
→ langage et décisions

modèle d'image
→ illustrations

modèle vocal
→ synthèse vocale

modèle vidéo
→ séquences

modèle d'embedding
→ représentations vectorielles
ERREUR
Cette architecture multi-modèles ne constitue pas automatiquement un système multi-agents.
Couche RAG
Composants :
connecteurs
extraction
nettoyage
chunking
embeddings
index
retrieval
reranking
citations
Elle doit intégrer :
- sécurité ;
- versioning ;
- provenance ;
- fraîcheur.
Couche tools
Les tools peuvent être exposés via :
- fonctions internes ;
- API ;
- MCP ;
- workflows ;
- services métier.
La couche applique les mêmes garde-fous à chaque appel, quel que soit le tool : un schéma et une validation en entrée, une autorisation sur la ressource exacte, une confirmation proportionnée au risque, une clé d’idempotence, une gestion explicite des erreurs et une trace. Aucun de ces contrôles n’est propre à un tool particulier ; c’est ce qui permet de les imposer une fois pour toutes.
Stockage et distribution des artefacts
Les tools multimédias peuvent produire des fichiers binaires.
Une couche dédiée gère le stockage objet, les identifiants, les types MIME, les URLs temporaires, les droits, les versions, la rétention, la suppression et la provenance.
EN PRATIQUE
Le contexte du LLM reçoit généralement une référence ou une description, pas nécessairement le fichier complet.
Mémoire et état
État
Stockage transactionnel du processus.
Mémoire
Stockage sélectif pour la continuité.
Historique
Conservation des messages selon la politique.
Source de vérité
Systèmes métier.
Important
Chaque stockage possède un rôle distinct.
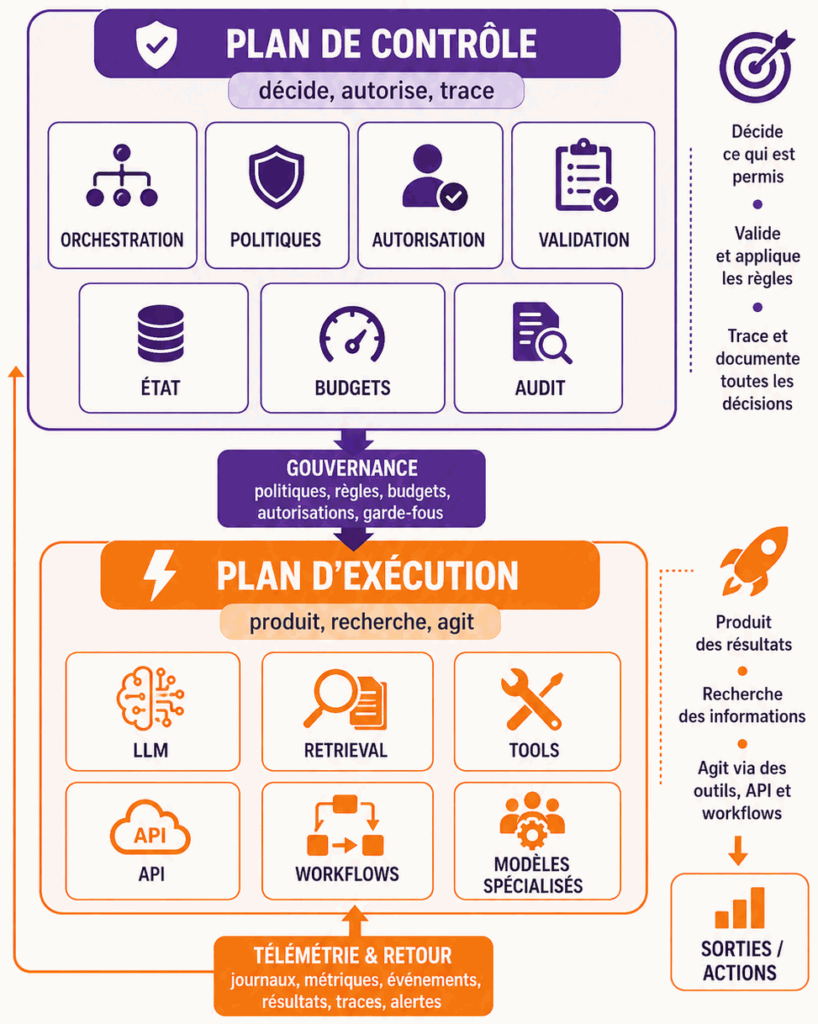
Appliquer le plan de contrôle
Le plan de contrôle rassemble ce qui décide comment le système peut fonctionner : politiques, validation, état, autorisation, sélection des modèles, budgets, confirmations et traces. Il ne produit pas nécessairement la réponse, mais il encadre tout ce qui peut y conduire.
Cette séparation évite de placer trop de responsabilité dans le LLM ou dans les tools.
Policy enforcement
Une couche de politique décide, avant tout appel, ce qui est permis : quel modèle et quel tool, sur quelles données et dans quelle région, au-delà de quel seuil une confirmation s’impose, quelle rétention s’applique et ce qui doit être filtré en sortie.
Les politiques doivent être évaluées en dehors du LLM.
Observabilité
L’architecture doit produire :
- traces ;
- logs ;
- métriques ;
- coûts ;
- feedback ;
- évaluations.
Chaque requête reçoit un identifiant de corrélation.
Plan de contrôle et plan d’exécution
Plan de contrôle
orchestration
politiques
sélection
validation
état
Plan d’exécution
LLM
retrieval
tools
API
workflows
Cette séparation facilite :
- gouvernance ;
- sécurité ;
- remplacement ;
- audit.
Choisir le déploiement et les qualités opérationnelles
L’architecture fonctionnelle ne suffit pas. Une solution d’entreprise doit aussi tenir en production : disponibilité, latence, coût, confidentialité, séparation des données, cycle de vie et capacité de reprise.
Cette section ne donne pas une recette universelle. Elle montre les critères qui permettent de choisir un déploiement et d’éviter les surprises opérationnelles.
Architecture locale, cloud ou hybride
Locale
Avantages :
- contrôle ;
- confidentialité ;
- fonctionnement hors ligne.
Limites :
- capacité ;
- exploitation ;
- mises à jour.
Cloud
Avantages :
- élasticité ;
- services managés ;
- modèles puissants.
Limites :
- dépendance ;
- transfert de données ;
- coûts.
Hybride
Exemple :
RAG interne
+ tools internes
+ modèle cloud
ou :
modèle local pour données sensibles
+ modèle cloud pour tâches générales
La décision dépend du cas d’usage.
Résilience
Les mécanismes classiques — timeout, retry, circuit breaker, fallback, cache, file d’attente, reprise, idempotence — visent tous le même but : dégrader honnêtement plutôt que d’échouer brutalement ou, pire, de simuler un succès.
Exemple :
modèle principal indisponible
→ modèle secondaire

tool critique indisponible
→ ne pas simuler le succès
→ transfert ou attente
Performance et coût
Les leviers agissent en amont du coût, pas après. On peut réduire ce qu’on envoie — modèle adapté à la tâche, contexte plus court, sélection de tools, résumé ; réutiliser ce qu’on a déjà — cache d’embeddings, cache de réponse ; et lisser la charge — batching, parallélisme, quotas.
Le coût doit être mesuré par :
requête
session
utilisateur
cas d'usage
résultat métier
Multi-tenant et séparation
Une plateforme partagée doit isoler chaque locataire à tous les niveaux où ses données transitent — pays, sociétés, domaines, utilisateurs — mais aussi là où on l’oublie le plus souvent : index, mémoire, logs et secrets. Une fuite par les logs vaut une fuite par la base.
La séparation logique doit être testée.
Cycle de vie
Un changement invisible dans l’interface peut modifier le comportement du système. Tout ce dont la modification altère ce comportement doit donc porter une version :
- modèle ;
- prompt ;
- workflow ;
- tool ;
- schéma ;
- corpus ;
- embeddings ;
- politiques ;
- jeux de tests.
Déploiement :
développement
→ test
→ validation
→ production
→ monitoring
→ rollback
Suivre les flux de référence Bikaroo
Pour éviter que l’architecture reste abstraite, on peut la relire à travers quelques flux types. Les mêmes briques ne sont pas mobilisées de la même manière selon qu’il s’agit d’une question documentaire, d’une donnée opérationnelle, d’une action sensible ou d’un agent qui poursuit un objectif.
Ces flux servent de pont entre la théorie et les ateliers pratiques.
Architecture exemple Bikaroo
Portail service à la clientèle
 ↓
Conversation API
 ↓
Orchestrateur Bikaroo
 ┌──────────────┬──────────────┬──────────────┐
 ↓              ↓              ↓              ↓
LLM           RAG Bikaroo   Mémoire      Tools MCP
 ↓                              ↓
 Procédures Bikaroo   CRM / Plateforme de flotte / Facturation
Contrôles :
SSO
OpenFGA / autorisation
confirmation d'écriture
audit
évaluation
monitoring
Flux : question documentaire
Utilisateur
→ orchestrateur
→ retrieval
→ chunks
→ LLM
→ réponse citée
Flux : donnée opérationnelle
Utilisateur
→ orchestrateur
→ tool
→ API
→ résultat
→ LLM
→ réponse
Flux : action sensible
Utilisateur
→ compréhension
→ préparation
→ policy check
→ confirmation
→ tool
→ système
→ audit
→ réponse
Flux : agent
Objectif
→ état
→ décision
→ tool/RAG
→ observation
→ nouvelle décision
→ condition d'arrêt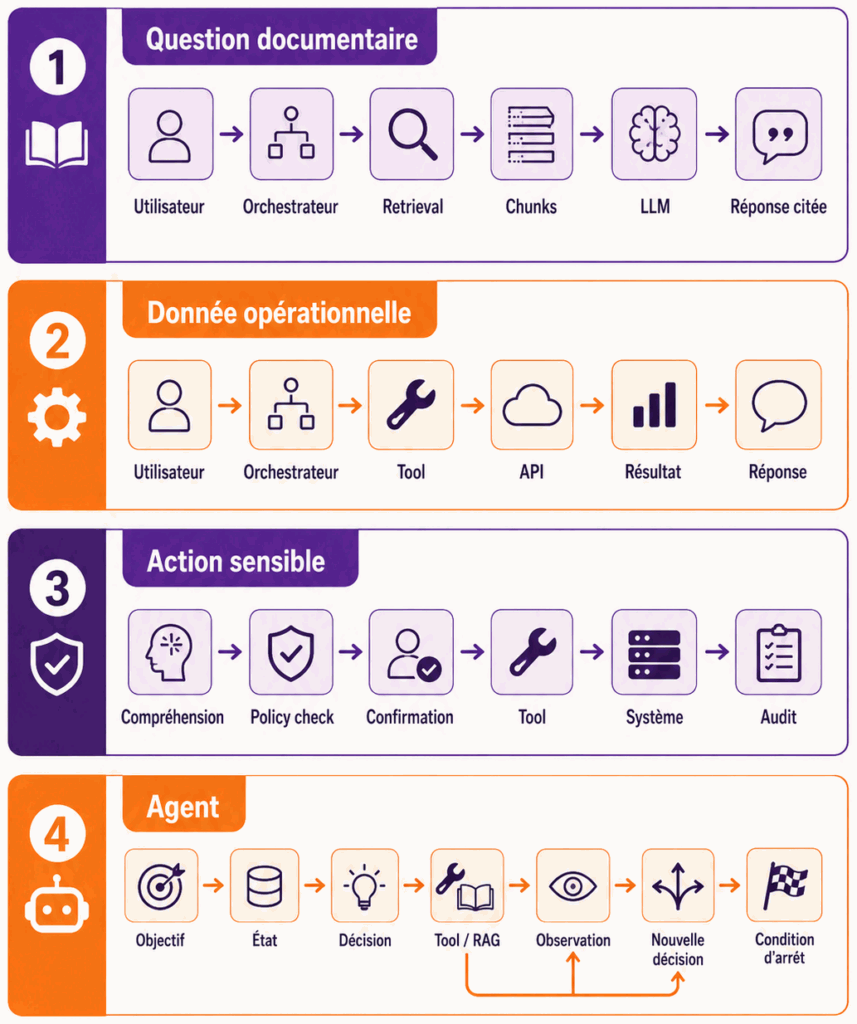
Faire évoluer la plateforme
Une architecture d’IA d’entreprise ne se construit généralement pas en une seule fois. Elle évolue avec les cas d’usage, la maturité de l’organisation, les contraintes de sécurité, les compétences disponibles et les retours de production.
La question n’est donc pas seulement “quelle architecture cible ?”, mais aussi “quelle trajectoire réaliste ?”.
Build versus buy
Le choix ne se tranche pas en général, mais question par question :
- différenciation métier ;
- maturité ;
- délai ;
- sécurité ;
- intégration ;
- coût ;
- verrouillage ;
- compétences ;
- exploitation.
Une plateforme ne remplace pas l’architecture. Elle fournit certaines briques.
Responsabilités d’équipe
Une dizaine de rôles se partagent la responsabilité, bien au-delà de la seule équipe technique :
- product owner ;
- architecte ;
- data owner ;
- knowledge manager ;
- AI engineer ;
- security ;
- legal ;
- operations ;
- métier ;
- support.
L’IA d’entreprise est multidisciplinaire.
Architecture minimale viable
Pour un premier assistant documentaire :
interface
orchestrateur simple
LLM
pipeline RAG
authentification
logs
jeu de tests
Il n’est pas nécessaire d’introduire immédiatement :
- multi-agent ;
- mémoire complexe ;
- MCP ;
- autonomie élevée.
L’architecture doit évoluer avec le besoin.
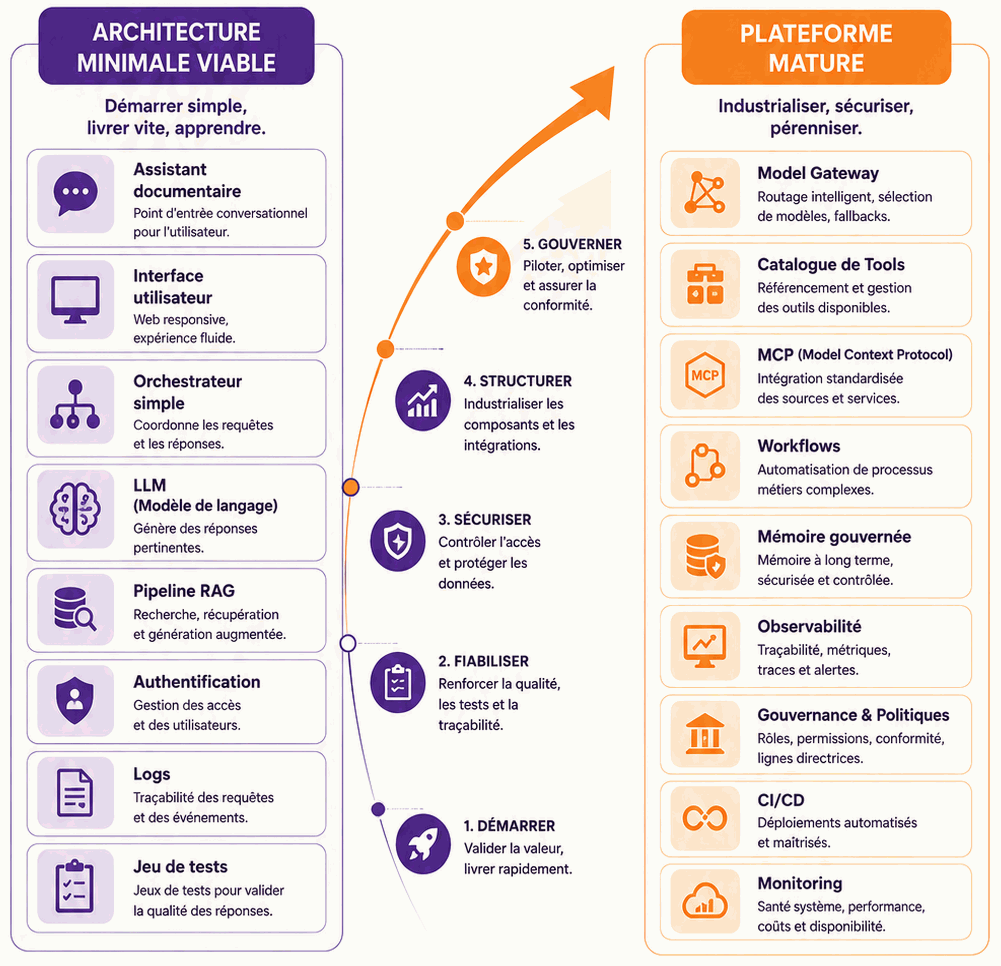
Roadmap de maturité
Ces six niveaux décrivent une trajectoire d’équipement, pas une échelle de valeur : un assistant documentaire soigné au niveau 2 vaut mieux qu’un agent bâclé au niveau 5. On ne monte d’un palier que lorsqu’un besoin réel le justifie — et le besoin, non le niveau atteint, est ce qui donne le signal.
Niveau 1 — Assistant. Un LLM et un prompt. Le point de départ : répondre en langage naturel, sans connaissance ni capacité d’action propres.
Niveau 2 — Connaissance. On ajoute le RAG quand les réponses doivent s’appuyer sur des sources internes, et non plus sur les seules connaissances générales du modèle.
Niveau 3 — Connexion. On ajoute les tools quand consulter ne suffit plus et qu’il faut agir sur les systèmes.
Niveau 4 — Contrôle. On ajoute l’orchestration et les politiques quand les actions deviennent sensibles et qu’une décision ne peut plus être laissée au seul modèle.
Niveau 5 — Agent limité. On ajoute une boucle et une mémoire quand le chemin n’est plus connu d’avance et doit s’adapter aux observations.
Niveau 6 — Plateforme. On ajoute gouvernance, observabilité et catalogue quand plusieurs cas d’usage et plusieurs équipes partagent la même fondation.
Anti-patterns
Ces anti-patterns signalent que l’architecture risque de perdre son objectif : produire de la valeur métier avec un niveau de contrôle adapté. Ils sont particulièrement fréquents lorsque l’on passe trop vite du prototype à la plateforme.
Ils ont aussi un point commun : une décision d’architecture paraît simplifier le système à court terme, mais déplace ensuite la complexité vers la sécurité, l’exploitation, les coûts ou la gouvernance. Il faut donc regarder non seulement si une architecture « fonctionne », mais aussi quelles garanties elle permet encore d’expliquer et de faire respecter lorsque les usages se multiplient.
LLM au centre de toutes les décisions
Faire passer toutes les décisions par le LLM peut sembler cohérent dans une architecture centrée sur l’IA. Mais des décisions déterministes — autorisation, règles métier obligatoires, limites budgétaires, validation d’une transaction — deviennent alors dépendantes d’un composant probabiliste.
Le même état peut produire des formulations ou propositions différentes, l’audit devient plus difficile et une erreur du modèle peut atteindre des opérations qui auraient dû être bloquées par des règles indépendantes. Le LLM doit intervenir là où l’interprétation apporte de la valeur ; les garanties critiques restent dans des composants capables de les imposer.
Architecture avant le cas d’usage
Construire d’abord une plateforme complète — gateway de modèles, mémoire, RAG, multi-agent, catalogue de tools et observabilité avancée — peut donner l’impression de préparer l’avenir. Mais si les besoins réels ne sont pas encore établis, chaque brique ajoute du coût, de l’exploitation et des dépendances sans valeur démontrée.
L’équipe risque alors de consacrer plus d’énergie à maintenir la fondation qu’à valider le problème métier. L’architecture doit grandir à partir de besoins observables et de contraintes réelles, plutôt que chercher à anticiper tous les usages possibles.
Plateforme unique pour tout
Mutualiser les fondations est utile, mais tous les cas d’usage n’ont pas les mêmes contraintes de données, de latence, de disponibilité, de permissions ou de coût. Forcer chaque solution dans une plateforme unique peut imposer à un petit assistant documentaire les contraintes d’un processus transactionnel sensible — ou, à l’inverse, sous-dimensionner un cas critique pour rester compatible avec le plus petit dénominateur commun.
Une plateforme commune doit donc proposer des capacités réutilisables sans supprimer la possibilité d’adapter les contrôles et les niveaux de service au contexte métier.
Copies de données non gouvernées
Une architecture IA crée facilement des copies : chunks dans un index RAG, éléments de mémoire, traces, caches, exports ou artefacts générés. Si ces copies n’ont pas de propriétaire, de durée de vie et de règles de synchronisation, elles peuvent continuer à exposer une information après sa correction ou sa suppression dans le système d’origine.
Le risque n’est donc pas seulement le stockage en double : c’est l’apparition de vérités divergentes et de politiques d’accès différentes selon l’endroit où se trouve la donnée. Toute copie utile doit avoir un rôle explicite et rester rattachée à une source de vérité et à un cycle de vie gouverné.
Absence de plan de contrôle
Connecter des modèles et des tools sans définir où sont appliquées les autorisations, validations, budgets, conditions d’arrêt et règles métier laisse le comportement effectif dépendre des propositions du modèle et du code local de chaque intégration.
À mesure que les capacités augmentent, il devient alors difficile de répondre à des questions simples : qui peut appeler ce tool, avec quelles données, jusqu’à quel montant, et qui bloque l’action si une condition n’est pas remplie ? Le plan de contrôle rend ces règles explicites et indépendantes de la seule conversation avec le LLM.
Multi-agent par défaut
Ajouter plusieurs agents peut donner une architecture plus spectaculaire et permettre une spécialisation réelle dans certains cas. Mais chaque agent supplémentaire introduit des appels de modèles, des échanges, de l’état, des permissions et de nouvelles possibilités de désaccord ou de boucle.
Sans besoin clair de séparation ou d’autonomie, le résultat est surtout davantage de coût et d’opacité : il devient plus difficile de reconstruire pourquoi une décision a été prise et quel composant en est responsable. Le multi-agent doit être une réponse à un problème identifié, pas un point de départ architectural.
Checklist finale — Une IA d’entreprise fiable
Avant de passer aux ateliers, une architecture d’IA d’entreprise devrait permettre de répondre à ces questions :
Qui demande ?
Quelles données sont utilisées ?
Quelle source fait autorité ?
Quel modèle est appelé ?
Quels outils peuvent agir ?
Quelles permissions s’appliquent ?
Quelles validations sont nécessaires ?
Quelle trace est conservée ?
Comment évaluer la réponse ?
Comment arrêter ou corriger le système ?
Cette checklist ne remplace pas l’architecture, mais elle révèle rapidement les zones floues.
En résumé
- Expérience — les canaux et interfaces par lesquels la demande arrive, sans logique agentique.
- Contrôle — l’orchestrateur, l’état, les politiques et la validation ; le plan qui décide ce qui est permis.
- Intelligence — le LLM, les embeddings, le RAG et les agents ; ce qui comprend et propose.
- Capacités — les tools, MCP et workflows ; ce qui agit, sous le contrôle du plan précédent.
- Systèmes — CRM, ERP, bases et documents ; les sources de vérité que rien ne remplace.
- Transverse — identité, sécurité, observabilité et audit ; ce qui traverse toutes les couches.
Le message essentiel est :
L’architecture doit séparer compréhension probabiliste, règles déterministes, exécution métier et gouvernance.
Vérifiez votre compréhension
Question 1 — Quel est le rôle de l’orchestrateur ?
Réponse : Il est le plan de contrôle : il construit le contexte, sélectionne le modèle, lance le retrieval, expose les tools, tient l’état, applique les workflows, demande les validations, surveille les budgets et trace. Il ne produit pas la réponse, il décide ce qui peut y conduire.
Question 2 — Pourquoi une model gateway ?
Réponse : Pour découpler l’application d’un modèle unique. La passerelle centralise le routage, les quotas, les versions, le fallback, le masquage et la mesure des coûts — de sorte que changer de fournisseur ou de version ne suppose pas de réécrire l’application.
Question 3 — Quelle différence entre état et mémoire ?
Réponse : L’état est le stockage transactionnel de la progression d’un processus, et il fait autorité sur ce dossier. La mémoire est un stockage sélectif au service de la continuité entre sessions ; elle aide sans faire autorité. Ni l’un ni l’autre ne remplace les systèmes métier.
Question 4 — Qu’est-ce que le policy enforcement ?
Réponse : La couche qui décide, en dehors du LLM, ce qui est autorisé : quel modèle, quel tool, quelles données, quel seuil, quelle région, quelle rétention, quel filtrage de sortie. Évaluer ces règles dans le modèle reviendrait à confier la sécurité au composant probabiliste.
Question 5 — Pourquoi séparer contrôle et exécution ?
Réponse : Parce que le plan de contrôle — orchestration, politiques, validation, état — doit rester lisible et auditable même quand le plan d’exécution — LLM, retrieval, tools, API — devient complexe. La séparation permet de gouverner, sécuriser, remplacer une brique et auditer sans démonter le reste.
Question 6 — Comment choisir local, cloud ou hybride ?
Réponse : Selon la sensibilité des données, la puissance requise, la tolérance à la dépendance et le coût. Le local offre contrôle et confidentialité mais plafonne en capacité ; le cloud offre l’élasticité et des modèles puissants au prix d’une dépendance et de transferts de données. L’hybride réserve le local aux données sensibles et le cloud aux tâches générales.
Question 7 — Quels artefacts versionner ?
Réponse : Tout ce dont un changement modifie le comportement du système : modèle, prompt, workflow, tool, schéma, corpus, embeddings, politiques et jeux de tests. Un artefact non versionné est un changement qu’on ne peut ni tracer ni annuler.
Question 8 — Pourquoi une architecture minimale ?
Réponse : Parce que la complexité doit suivre le besoin, pas le précéder. Un premier assistant documentaire n’a besoin que d’une interface, d’un orchestrateur simple, d’un LLM, d’un pipeline RAG, d’une authentification, de logs et de tests. Le multi-agent, la mémoire élaborée ou MCP s’ajoutent quand un besoin réel les justifie.
Question 9 — Comment mesurer le coût ?
Réponse : Par unité qui a un sens métier : par requête, par session, par utilisateur, par cas d’usage et surtout par résultat métier. Un coût moyen par requête peut être bas alors que le coût par dossier réellement résolu est élevé.
Question 10 — Quand introduire un agent ?
Réponse : Quand le chemin n’est pas connu d’avance et doit s’adapter à des observations — et seulement après avoir posé les niveaux inférieurs : connaissances, outils, orchestration et politiques. Un agent ajouté avant le plan de contrôle hérite d’une autonomie que rien n’encadre.
Transition vers les ateliers
Les quatorze premiers chapitres ont construit une carte complète : chaque brique possède maintenant un rôle, une limite et une place dans l’architecture. La compréhension doit désormais être éprouvée par la construction.
Le chapitre suivant sera :
Chapitre 15 — Construire l’Assistant Bikaroo
Atelier 1 — Créer un chatbot local avec Ollama
Nous partirons d’un assistant minimal, puis les ateliers suivants ajouteront progressivement les connaissances, les tools, l’orchestration, la sécurité et l’observabilité lorsque le besoin les rend nécessaires.