Ouvrir le capot de l’IA
Que voit l’IA sur cette photo?
Au-delà du texte : comment un modèle comprend-il différents types d’entrées ?
Introduction — Quand la question ne tient plus dans une phrase
Stéphane : Ce vélo semble endommagé. Peux-tu regarder la photo et me dire ce que tu observes ?
Assistant Bikaroo : Je peux analyser l’image et décrire les éléments visibles, mais cette observation ne remplace pas encore le diagnostic d’un technicien.
Dans le chapitre précédent, nous avons suivi une demande textuelle depuis le prompt jusqu’à la réponse générée token après token. Ce modèle mental reste valable, mais les applications d’IA modernes ne reçoivent pas uniquement du texte.
Stéphane peut envoyer une photographie d’un vélo, dicter une question ou joindre un document. Marie peut consulter une procédure mêlant texte, tableau et schéma. Dans chaque cas, l’application doit transformer l’entrée brute en représentations numériques que le modèle peut traiter.
Ce chapitre se concentre sur la compréhension des entrées multimodales. La génération d’images, de sons ou de vidéos sera distinguée de cette capacité, sans être étudiée en détail à ce stade.
Ce que vous allez apprendre
À la fin de ce chapitre, vous pourrez :
- expliquer ce qu’est une modalité et ce que signifie multimodal ;
- décrire comment le texte, l’image, l’audio, la vidéo et les documents sont préparés pour un modèle ;
- distinguer extraction textuelle, perception visuelle et encodage natif d’une modalité ;
- expliquer comment plusieurs modalités peuvent être mises en relation ;
- identifier les principales limites, les coûts et les risques d’une entrée multimodale.
Scénarios fil rouge
Nous utiliserons plusieurs interactions Bikaroo pour garder le raisonnement concret :
- Texte : Stéphane demande comment fonctionne son abonnement Semi-Pro League.
- Image : il transmet la photographie d’un vélo et demande quels dommages sont visibles.
- Audio : il dicte que son trajet est toujours ouvert alors qu’il a rendu le vélo.
- Document : Marie ouvre une procédure contenant du texte, un tableau et un schéma, puis demande quelles étapes appliquer.
Ces situations semblent très différentes pour l’utilisateur. Pour le système, elles partagent pourtant un même principe : chaque entrée doit être préparée, encodée et mise en relation avec la demande avant de pouvoir contribuer à une réponse.
Comprendre la multimodalité
Qu’est-ce qu’une modalité ?
Une modalité est une forme particulière de représentation de l’information.
Chaque modalité se présente sous une forme brute, qui porte un type d’information particulier :
- Texte : caractères et tokens → mots, phrases, structure linguistique.
- Image : pixels → couleurs, formes, objets, relations spatiales.
- Audio : échantillons d’un signal → parole, sons, rythme, intonation.
- Vidéo : images successives et audio → contenu visuel, mouvement, temporalité.
- Document : texte, images et mise en page → contenu, structure, tableaux, diagrammes.
Un ordinateur ne voit, n’entend ou ne lit pas au sens humain. Il reçoit des données numériques. Des composants d’encodage transforment ces données brutes en représentations exploitables par le modèle.
Modèle textuel et modèle multimodal
Un modèle uniquement textuel reçoit des tokens textuels et génère des tokens textuels :
Texte → Tokenizer → Tokens → LLM → Tokens → TextePour lui faire traiter une image, une application peut utiliser un composant intermédiaire qui produit une description :
Image → Modèle de vision → Description textuelle → LLMUn modèle multimodal, lui, peut recevoir des représentations issues de plusieurs modalités :
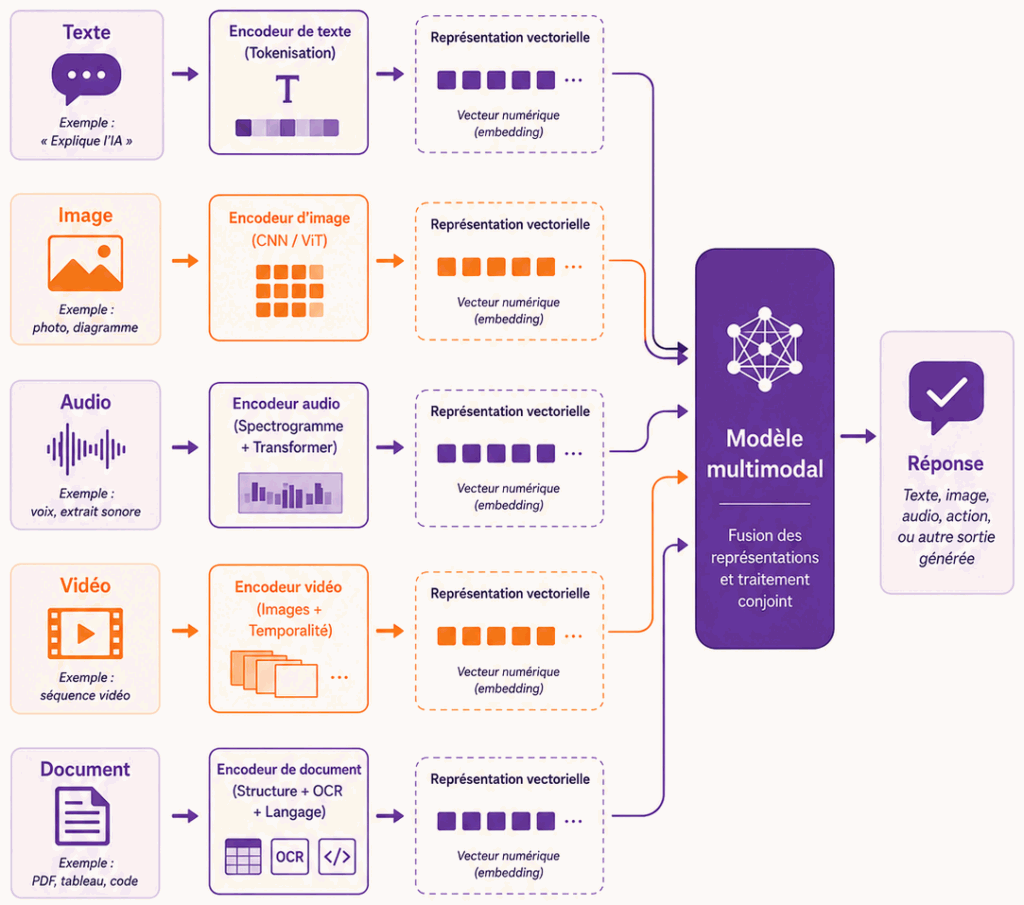
Il doit ensuite mettre ces représentations en relation. Pour répondre à la question « Quel monument apparaît sur cette photo ? », il doit associer les mots de la question aux formes de l’image et aux concepts appris pendant son entraînement.
Une idée centrale : tout devient une représentation numérique
Le modèle ne reçoit pas directement « une photographie », « une voix » ou « une page de rapport ». Chaque modalité emprunte un chemin d’entrée différent, mais finit sous une forme numérique que le modèle peut manipuler.
Donnée brute
    ↓
Encodage adapté à la modalité
    ↓
Représentations numériques
    ↓
Traitement neuronal
Le terme embedding est parfois utilisé de manière large pour désigner une représentation numérique condensée. Il ne faut cependant pas en conclure que toutes les modalités sont encodées de la même façon.
Du texte à l’image
Entrée textuelle : rappel
Comme nous l’avons vu au chapitre précédent, le texte est découpé en tokens, transformé en vecteurs puis contextualisé par le Transformer.
Nous partons maintenant de ce mécanisme connu pour observer ce qui change lorsque l’entrée n’est plus constituée uniquement de texte.
Des pixels à une représentation visuelle
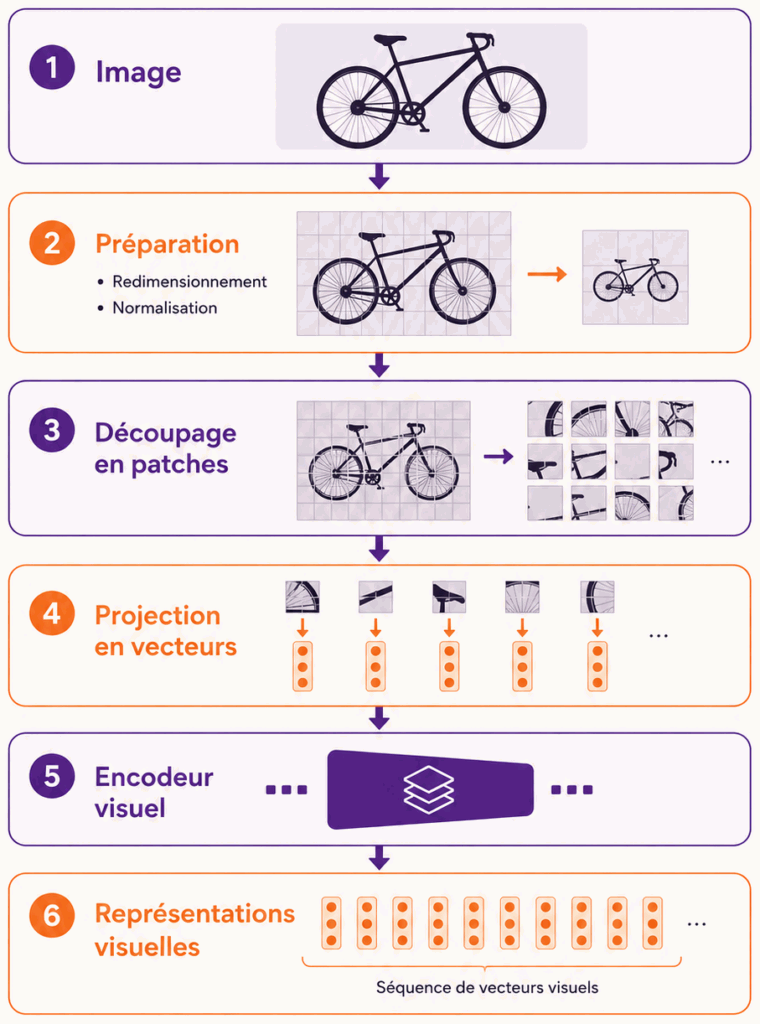
Une image est une grille de pixels. Chaque pixel contient des valeurs numériques, généralement associées aux canaux rouge, vert et bleu. Envoyer chaque pixel individuellement au modèle serait toutefois peu efficace.
Une approche fréquente consiste à préparer l’image, puis à la découper en petites zones appelées patches :
Image
  ↓
Redimensionnement et normalisation
  ↓
Découpage en patches
  ↓
Vecteurs visuels
  ↓
Encodeur visuel
Chaque patch devient une unité visuelle transformée en vecteur. Un patch ne correspond pas nécessairement à un objet ou à un mot : il peut contenir une texture, une bordure, une partie de roue ou plusieurs éléments mélangés.
L’encodeur visuel combine ensuite ces informations. Les premières couches peuvent représenter des contours, des couleurs ou des textures ; les couches plus profondes peuvent faire émerger des objets, des formes et des relations spatiales.
Dans la photographie du vélo de Stéphane, le système peut ainsi représenter progressivement :
roue
cadre
guidon
rayures
élément tordu
position relative des composants
Ces représentations ne constituent pas encore un diagnostic mécanique. Elles décrivent ce que le modèle parvient à percevoir dans l’image.
Exemple de découpage en patches
Une image de 224 × 224 pixels découpée en zones de 16 × 16 pixels produit 14 × 14, soit 196 patches. Ces dimensions illustrent le principe ; les modèles réels peuvent employer d’autres résolutions et méthodes de découpage.
Mettre l’image en relation avec la question
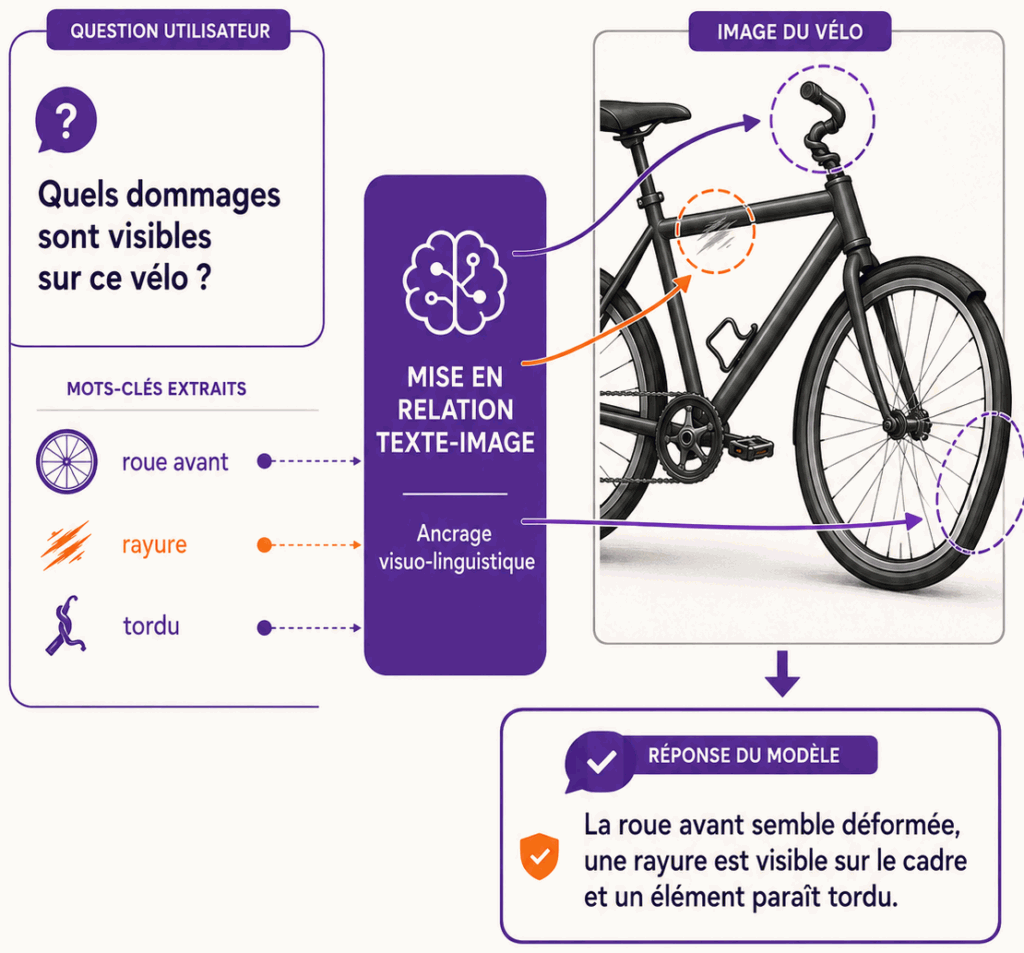
L’utilisateur fournit généralement une image et une question. Le système doit donc combiner deux flux :
Question → Tokenizer → Représentations textuelles ──┐
                                                    ├──→ Modèle multimodal
Image → Encodeur visuel → Représentations visuelles ┘
Pour répondre à « Quels dommages sont visibles sur ce vélo ? », le modèle doit relier les termes dommages et vélo à certaines zones et caractéristiques de l’image.
Cette capacité est souvent appelée ancrage visuo-linguistique ou visual grounding :
Le modèle relie des éléments de la question à des zones ou représentations pertinentes de l’image.
Trois manières de traiter une image
Transformer une image en quelque chose que le modèle peut relier à une question ne se fait pas toujours de la même manière. Trois grandes approches coexistent selon l’architecture choisie, chacune avec ses compromis.
La première consiste à passer par une description intermédiaire : un modèle de vision analyse l’image et produit un texte que le LLM traite ensuite normalement. C’est l’architecture la plus simple à comprendre et à déboguer, mais la description peut trahir certains détails visuels que le texte ne restitue pas fidèlement.
La deuxième est le traitement multimodal direct : l’image est encodée en vecteurs visuels et injectée directement dans le même espace de représentation que le texte. Le modèle peut alors relier un élément de la question à une zone précise de l’image, sans passer par une phrase intermédiaire. C’est plus fin, mais aussi plus exigeant sur le plan technique.
La troisième mobilise un OCR spécialisé lorsque l’essentiel de l’information utile est du texte imprimé ou manuscrit — un formulaire, un panneau, une capture d’écran. Un moteur OCR extrait ce texte avec précision, mais il ne comprend pas la scène dans son ensemble.
Ces trois approches se résument ainsi :
- Description intermédiaire — le LLM reçoit un texte produit par un modèle de vision. Atout : architecture simple et modulaire. Limite : perte possible de détails visuels.
- Traitement multimodal direct — le LLM reçoit des représentations visuelles. Atout : relation plus fine entre image et question. Limite : calcul et intégration plus complexes.
- OCR spécialisé — le LLM reçoit le texte détecté dans l’image. Atout : efficace pour panneaux, formulaires et captures d’écran. Limite : ne comprend pas à lui seul toute la scène.
Ces approches peuvent être combinées. Une application peut extraire le texte avec un OCR tout en conservant l’image pour analyser la mise en page ou les objets visibles.
Résolution, détails et coût
Une meilleure résolution peut aider à détecter un petit objet, une fissure ou un texte minuscule, mais elle augmente aussi :
- le nombre d’unités visuelles ;
- le temps de traitement ;
- la mémoire nécessaire ;
- le coût de la requête.
DANS LA PRATIQUE
L’application doit donc trouver un compromis entre précision et coût. Une image trop compressée peut perdre l’information utile ; une image inutilement détaillée peut consommer beaucoup de contexte sans améliorer la réponse.
Audio, vidéo et documents
Le texte et l’image ne sont pas les seules entrées qu’un système multimodal peut recevoir. Une demande vocale, une vidéo ou un document structuré posent chacun leurs propres défis d’encodage — et leurs propres compromis entre fidélité, coût et complexité.
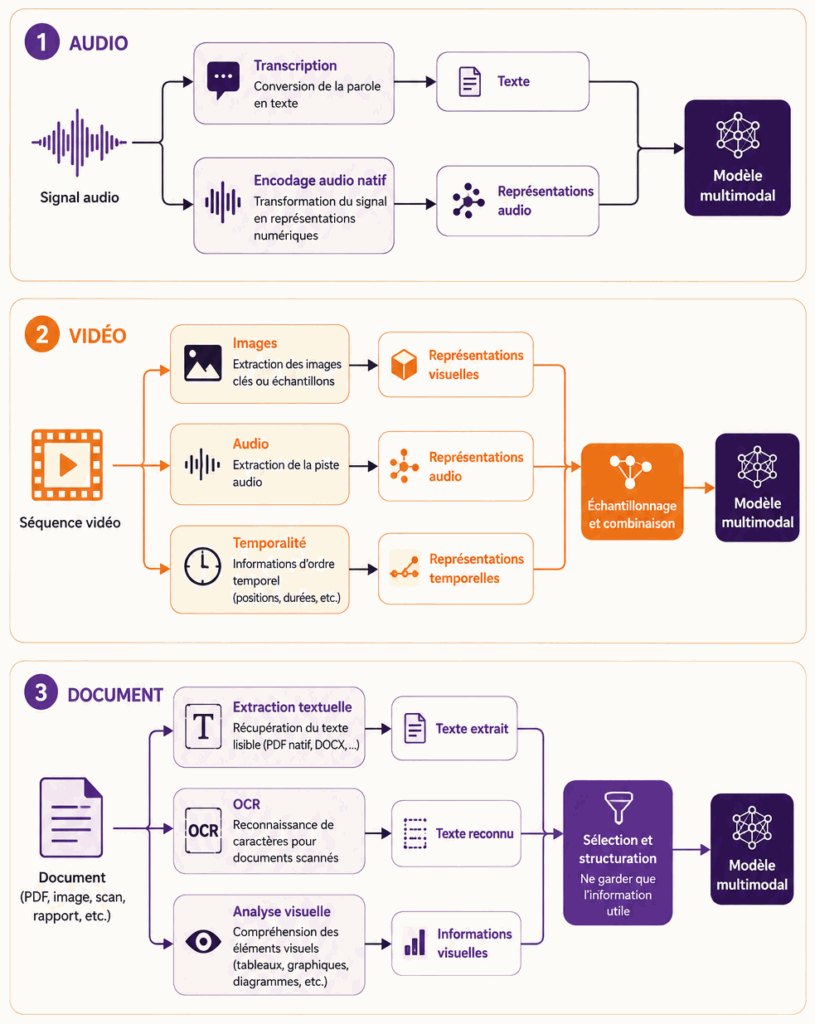
Les trois sections qui suivent examinent comment ces modalités sont traitées avant d’atteindre le modèle.
Audio : transcription ou traitement natif
Un signal audio varie dans le temps. Deux approches principales permettent de l’exploiter : passer par une transcription textuelle intermédiaire, ou confier l’encodage à un modèle multimodal capable de traiter l’audio directement.
- Transcription intermédiaire — audio → reconnaissance vocale → texte → LLM. Simple, modulaire et facile à contrôler, mais perd potentiellement intonation, rythme et sons non verbaux.
- Encodage direct — audio → encodeur audio → modèle multimodal. Peut conserver davantage d’informations acoustiques, mais plus complexe et plus coûteux.
Selon l’architecture, l’audio peut être représenté par des trames temporelles, des spectrogrammes ou des tokens audio appris. Ces tokens ne correspondent pas nécessairement à des mots ; ils peuvent représenter des fragments acoustiques.
La transcription est souvent suffisante lorsque seul le contenu verbal compte. Elle peut toutefois perdre :
- l’intonation ;
- les hésitations ;
- le rythme ;
- l’émotion ;
- les bruits environnants ;
- la présence de plusieurs voix.
La langue parlée introduit aussi ses propres difficultés : accents, dialectes, bruit, vocabulaire spécialisé ou alternance entre plusieurs langues. À Bruxelles, un même échange peut mélanger Bruxelles, Brussel et Brussels.
Vidéo : ajouter la temporalité
Une vidéo combine :
images successives
+ mouvement
+ audio
+ texte visible éventuel
+ temporalité
Le modèle doit comprendre non seulement ce qui apparaît, mais aussi dans quel ordre les événements se produisent. Une séquence montrant une tasse tenue, puis lâchée, puis brisée contient une relation temporelle et éventuellement causale qu’une image isolée ne révèle pas.
Comme une vidéo peut contenir des milliers d’images, le système sélectionne souvent :
- des images à intervalles réguliers ;
- des images clés ;
- des scènes où un changement est détecté ;
- des extraits jugés importants.
LIMITE
Cette stratégie réduit le coût, mais crée une limite : un événement très bref peut être manqué s’il ne se trouve dans aucune image sélectionnée.
Documents : texte, structure et éléments visuels
Un PDF n’est pas une modalité homogène. Il peut contenir :
- des paragraphes ;
- des titres et des colonnes ;
- des tableaux ;
- des images ;
- des graphiques ;
- des diagrammes ;
- des notes de bas de page ;
- une mise en page porteuse de sens.
Trois approches sont courantes :
- Extraction textuelle — adaptée aux paragraphes simples et aux documents numériques ; peut perdre l’ordre de lecture et la mise en page.
- OCR — adapté aux pages scannées et aux photographies de documents ; erreurs de reconnaissance et structure imparfaite.
- Analyse visuelle — adaptée aux tableaux, graphiques, formulaires et diagrammes ; coût supérieur et précision variable.
Une application d’entreprise combine souvent ces méthodes :
Document
  ↓
Extraction du texte + OCR + détection de structure
  ↓
Analyse ciblée des tableaux et images
  ↓
Informations utiles transmises au modèle
Pour un tableau, la relation entre lignes et colonnes est essentielle. Pour un graphique, il faut relier les axes, la légende et les valeurs. Pour un diagramme d’architecture, les positions et les flèches portent une partie du sens. Une extraction de texte seule peut donc être insuffisante.
EN PRATIQUE
Et les données structurées ?
Un petit objet JSON, un fichier XML ou un tableau raisonnable peuvent être transmis comme du texte. Pour de gros volumes ou des calculs exacts, l’application doit généralement interroger un système spécialisé puis fournir uniquement le résultat utile au modèle. Nous reviendrons sur cette architecture dans les chapitres consacrés aux outils.
Combiner plusieurs modalités
Jusqu’ici, chaque modalité a été examinée séparément. Dans une application réelle, texte, image, audio et documents arrivent souvent ensemble, ou se succèdent au fil d’une même conversation. La question devient alors : comment un système fait-il coexister ces entrées de natures différentes pour produire une réponse cohérente ?
Trois grandes familles d’architectures répondent à ce défi, chacune avec une philosophie différente quant à l’endroit où la fusion entre modalités a lieu.
Ce chapitre présente plusieurs distinctions en trois volets : trois manières de traiter une image, trois traitements de document, et maintenant trois familles d’architectures. Elles ne se recouvrent pas. Les premières décrivent le traitement d’une modalité isolée ; celles qui suivent décrivent l’organisation générale du système.
Trois familles d’architectures
- Pipeline spécialisé — chaque modalité est traitée par un composant séparé avant le LLM. Avantage : simple et remplaçable. Limite : pertes entre les étapes et latence.
- Modèle multimodal intégré — plusieurs encodeurs alimentent un modèle commun. Avantage : relations plus riches entre modalités. Limite : entraînement et déploiement plus complexes.
- Représentation unifiée — texte, image ou audio sont transformés en unités traitées dans une séquence commune. Avantage : mécanisme plus homogène. Limite : formats spécifiques au modèle et coût élevé.
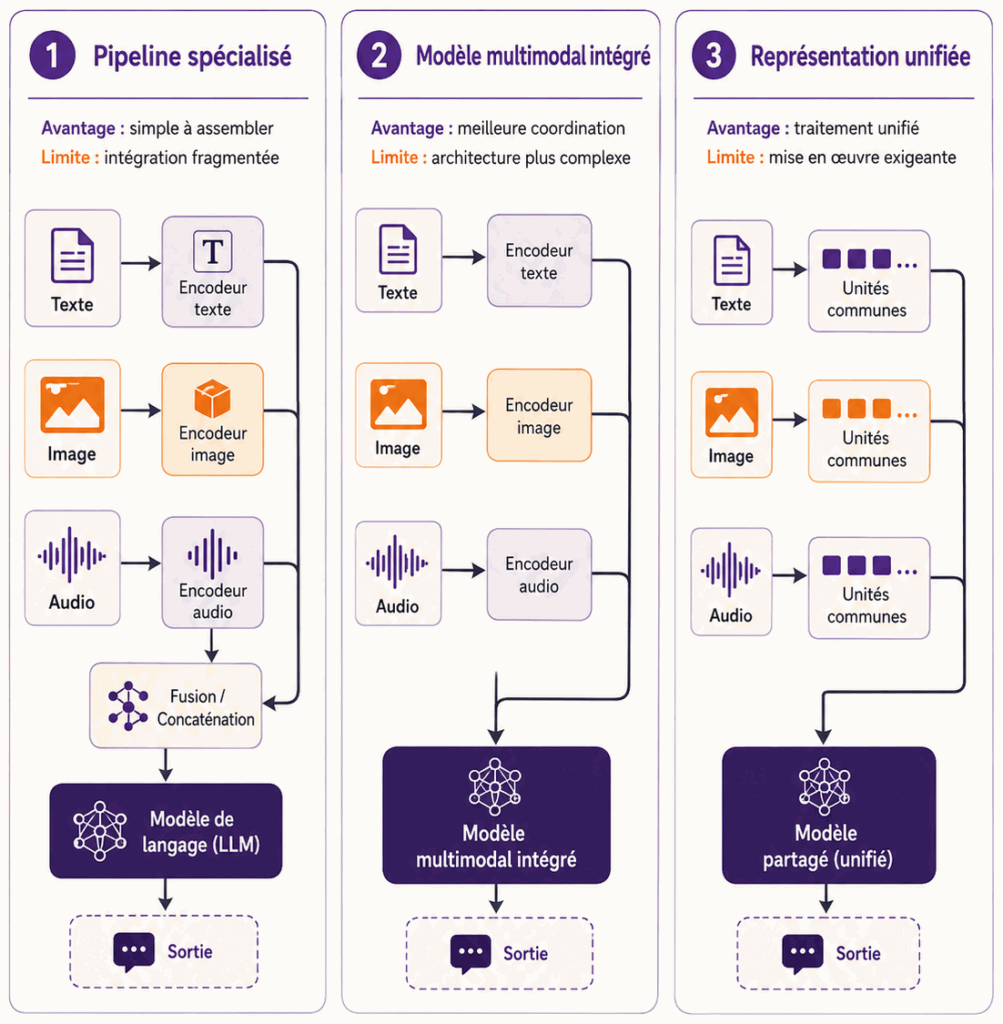
Le choix entre ces trois familles dépend du contexte. Un pipeline spécialisé convient bien lorsque les modalités sont traitées séquentiellement et que chaque composant peut être remplacé ou amélioré indépendamment — au prix d’une perte d’information à chaque passage. Un modèle multimodal intégré permet des relations plus riches entre modalités, notamment grâce à une couche de projection qui harmonise les vecteurs produits par des encodeurs de dimensions différentes avant de les fusionner ; c’est l’architecture la plus courante dans les modèles récents. Une représentation unifiée pousse cette logique plus loin en traitant toutes les modalités comme une séquence commune, ce qui simplifie le mécanisme de traitement mais rend le système plus dépendant des choix d’encodage propres à chaque modèle.
La fusion multimodale met ensuite les informations en relation. Face à une photographie de l’Atomium et à la question « Où se trouve ce monument ? », le système doit associer :
représentation visuelle
↕
concept « Atomium »
↕
connaissance « Bruxelles »
Cette relation est apprise à partir de nombreux exemples associant différentes modalités.
Le coût du contexte multimodal
Les images, les séquences audio et les pages de documents consomment elles aussi de la capacité de contexte.
Contexte total
=
instructions
+ historique
+ texte
+ unités visuelles
+ unités audio
+ documents
+ réponse à générer
Une image peut représenter des centaines ou des milliers d’unités visuelles. Un long enregistrement produit de nombreuses représentations audio. Un PDF de 200 pages dépasse souvent ce qu’un modèle peut traiter en une seule requête.
L’application doit donc sélectionner, réduire ou résumer les entrées pertinentes. La fenêtre de contexte reste limitée, même pour un modèle multimodal.
Limites et types de sorties
Multimodal ne signifie pas omniscient
La capacité à recevoir une modalité ne garantit pas une compréhension parfaite.
- Texte — ambiguïté, contexte trop long, erreur factuelle.
- Image — petits objets, comptage, texte minuscule, profondeur, flou.
- Audio — bruit, accents, voix qui se chevauchent, noms propres.
- Vidéo — événements brefs, causalité, longue durée, scènes non échantillonnées.
- Document — colonnes, tableaux complexes, pages scannées, ordre de lecture.
La prudence de l’assistant Bikaroo dans l’introduction est donc importante : repérer une roue déformée ou une rayure ne remplace pas l’expertise d’un technicien.
Perception et génération multimodales
Il faut distinguer deux directions :
Perception multimodale
image, audio ou document → interprétation et réponse

Génération multimodale
instruction → image, audio, vidéo ou document
Comprendre une image et en générer une ne reposent pas nécessairement sur les mêmes modèles ni sur les mêmes architectures. Une application peut coordonner un modèle de langage et un générateur spécialisé, mais cela ne signifie pas que le LLM textuel produit lui-même tous les formats.
Exemple de bout en bout : la photographie du vélo
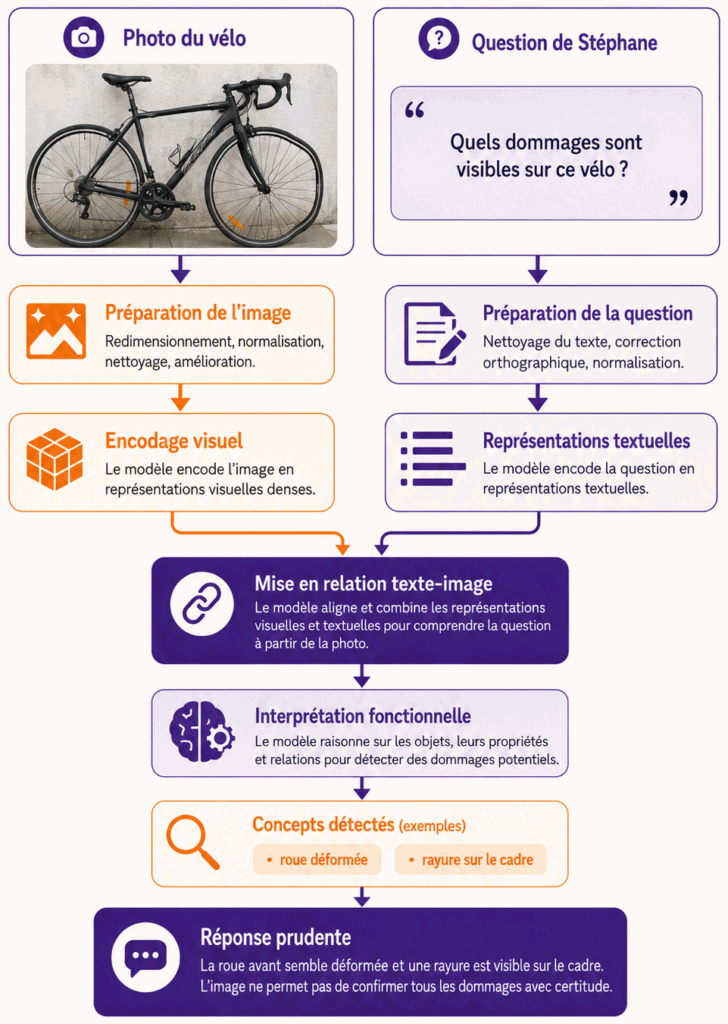
Stéphane transmet une photographie et demande :
Quels dommages sont visibles sur ce vélo ?
Le traitement peut être résumé ainsi :
- Préparation de l’image
L’application vérifie le format, redimensionne l’image et la normalise. - Encodage visuel
L’image est découpée ou analysée par un encodeur qui produit des représentations visuelles. - Préparation de la question
Le texte est tokenisé et transformé en représentations textuelles. - Mise en relation
Le modèle relie les mots dommages et vélo aux zones pertinentes de l’image. - Interprétation fonctionnelle
Il peut représenter, par exemple, une roue qui semble déformée, une rayure sur le cadre ou un élément mal aligné. - Génération de la réponse
Le modèle produit une réponse textuelle, token après token. - Application des limites
La réponse doit distinguer ce qui est visible de ce qui nécessiterait une inspection physique.
Une réponse prudente pourrait être :
La roue avant semble déformée et le cadre présente une rayure visible. Je ne peux toutefois pas confirmer l’état mécanique du vélo à partir de la photo seule.
Consolider le modèle mental
Le principe en deux formulations
Une formulation complète :
Un modèle multimodal ne transforme pas nécessairement toutes les entrées en mots. Chaque modalité est d’abord convertie en représentations numériques par un encodeur adapté. Ces représentations sont ensuite rendues compatibles et mises en relation afin de produire une interprétation commune.
Une formulation courte :
Texte, image et audio empruntent des chemins d’entrée différents, mais finissent sous forme de représentations numériques que le modèle peut mettre en relation.
Cinq erreurs fréquentes
Erreur 1 — « Une image est toujours transformée en description textuelle »
Pas nécessairement. Un modèle multimodal peut recevoir directement des représentations visuelles.
Erreur 2 — « Les patches sont des mots visuels »
Non. Un patch est une zone de l’image pouvant contenir une texture, une partie d’objet ou plusieurs éléments.
Erreur 3 — « Un système audio travaille toujours sur une transcription »
Non. Certains modèles traitent directement des représentations acoustiques.
Erreur 4 — « Un PDF est simplement un fichier texte »
Non. La mise en page, les tableaux, les graphiques et les images peuvent porter une partie essentielle du sens.
Erreur 5 — « Comprendre une image et en générer une sont la même fonction »
Non. La perception et la génération peuvent utiliser des modèles et des architectures différents.
Synthèse par modalité
- Texte : tokenisation → vecteurs textuels.
- Image : redimensionnement, patches, encodage → vecteurs visuels.
- Audio : transcription ou encodage natif → texte, vecteurs ou tokens audio.
- Vidéo : échantillonnage et analyse temporelle → vecteurs visuels, audio et temporels.
- Document : extraction, OCR et analyse de structure → texte, positions et vecteurs visuels.
En résumé
Après le chapitre 1, notre modèle mental était essentiellement textuel :
Texte → LLM → TexteIl devient maintenant :
Texte ─────┐
Image ─────┤
Audio ─────┼──→ Encodages adaptés → Représentations numériques
Vidéo ─────┤                              ↓
Document ──┘                     Modèle multimodal → Réponse
Un modèle multimodal peut donc mettre en relation plusieurs formes d’information. Cela ne signifie pas qu’il perçoit parfaitement les données, qu’il peut traiter un volume illimité ou qu’il génère automatiquement toutes les modalités qu’il comprend.
Le principe essentiel est le suivant :
Les modalités diffèrent par leur forme brute et leur méthode d’encodage, mais elles doivent toutes devenir des représentations numériques exploitables par le modèle.
Vérifiez votre compréhension
Question 1 — Qu’est-ce qu’une modalité ?
Réponse : Une forme particulière de représentation de l’information, comme le texte, l’image ou l’audio.
Question 2 — Un patch correspond-il toujours à un objet complet ?
Réponse : Non. Il peut ne contenir qu’une texture, une partie d’objet ou plusieurs éléments.
Question 3 — Pourquoi une transcription audio peut-elle perdre de l’information ?
Réponse : Elle conserve surtout les mots et peut perdre l’intonation, le rythme, l’émotion ou les sons non verbaux.
Question 4 — Pourquoi un PDF est-il souvent multimodal ?
Réponse : Il peut combiner texte, images, tableaux, graphiques et mise en page.
Question 5 — Pourquoi une vidéo est-elle plus complexe qu’une image ?
Réponse : Elle ajoute le mouvement, l’audio et l’ordre temporel des événements.
Question 6 — Un modèle qui comprend des images peut-il forcément en générer ?
Réponse : Non. La perception et la génération sont deux capacités distinctes.
Question 7 — Quelle idée commune relie toutes les modalités ?
Réponse : Elles doivent être converties en représentations numériques que le modèle peut traiter et mettre en relation.
Transition vers le chapitre suivant
Ce chapitre a montré comment une application peut préparer et combiner du texte, des images, de l’audio, de la vidéo et des documents. Pourtant, accepter plusieurs modalités ne suffit pas à transformer un modèle en solution d’entreprise.
Une nouvelle question se pose :
Combien de vélos sont disponibles près de la place Flagey ?
Pour répondre correctement, le système devra tenir compte de ses instructions, de la fenêtre de contexte, des paramètres de génération et des limites de la connaissance contenue dans le modèle. Il devra également distinguer ce que le LLM peut produire seul de ce qui exige des données actuelles ou une connexion à un système externe.
Le chapitre suivant sera :
Chapitre 3 — Combien de vélos sont disponibles près de la place Flagey ?
Piloter un LLM et comprendre les limites d’une solution prête à l’emploi
Il explore ces limites et montre pourquoi un modèle multimodal ne constitue pas encore, à lui seul, une application fiable.