Ouvrir le capot de l’IA
Pourquoi redéfinir le même outil dans chaque application ?
MCP : standardiser l’exposition des capacités aux applications d’IA
Introduction — Du connecteur local au contrat partagé
Marie : L’assistant du service à la clientèle sait consulter l’état d’un vélo. Pourquoi faut-il redéfinir la même capacité dans chaque application ?
Architecte de Bikaroo : Il ne faudrait pas redéfinir son contrat à chaque fois. Les applications ont besoin d’une manière commune de découvrir et d’appeler les capacités autorisées.
Le point de vue change ici : Marie dialogue avec l’architecte responsable de la manière dont les capacités sont partagées entre plusieurs applications Bikaroo.
Le chapitre précédent a montré comment une application peut présenter un outil au LLM, valider ses arguments, contrôler les droits et exécuter l’opération dans un système métier.
Le chapitre précédent s’intéressait donc à la sécurité d’exécution d’un appel d’outil : vérifier les arguments, les droits, les confirmations et le résultat de l’opération. Ici, la question se déplace vers la sécurité d’exposition : quels serveurs MCP l’hôte accepte-t-il, quelles capacités découvre-t-il, lesquelles présente-t-il au modèle, et avec quelles limites ?
Dans un prototype, quelques outils décrits directement dans l’application suffisent :
get_bike_status
report_damaged_bike
create_support_ticket
À l’échelle de Bikaroo, plusieurs applications peuvent cependant vouloir utiliser les mêmes capacités :
Assistant Customer Care
IDE des développeurs
Assistant des opérations
Orchestrateur de processus
Application mobile interne
Sans contrat commun, chaque application reconstruit :
- la connexion ;
- la découverte des capacités ;
- leurs descriptions ;
- leurs schémas ;
- la gestion des erreurs ;
- parfois l’authentification ;
- la transformation des résultats.
Le Model Context Protocol, ou MCP, propose un protocole ouvert permettant à une application d’IA de communiquer de manière standardisée avec des serveurs qui exposent des capacités et des contenus.
Il faut toutefois éviter une première confusion :
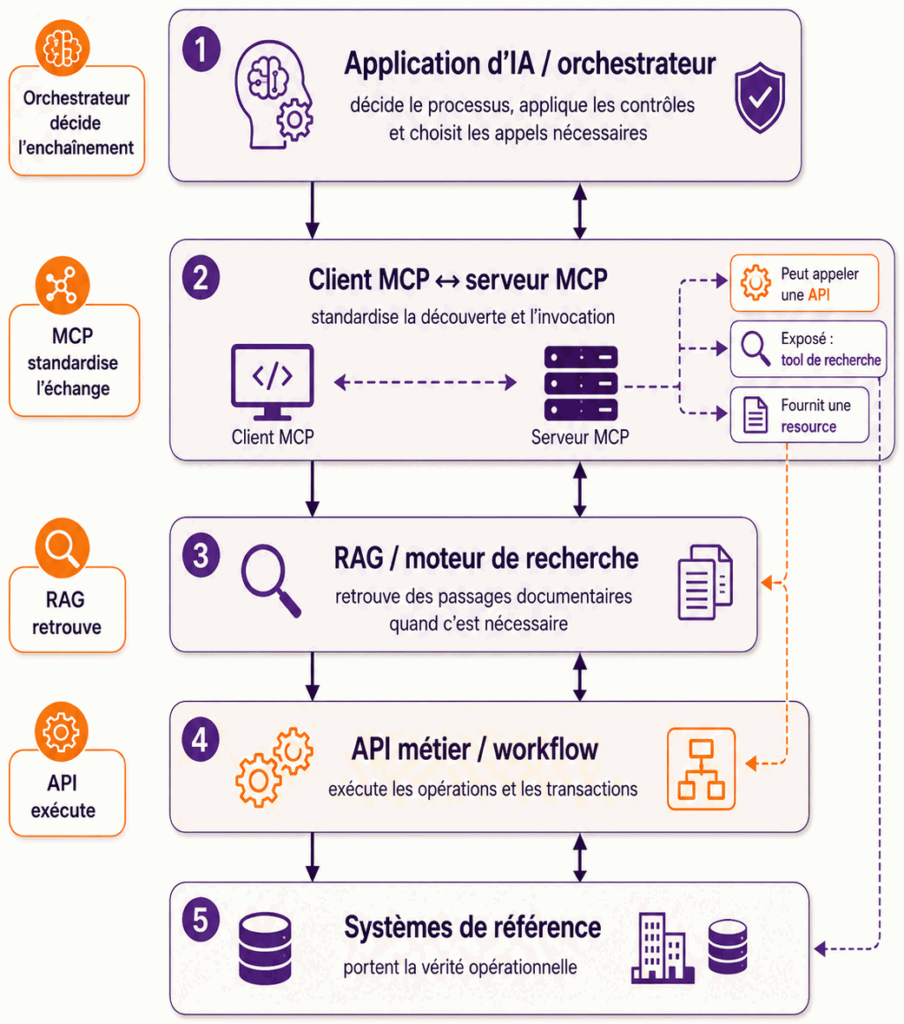
MCP ne remplace ni les API métier, ni les règles d’autorisation, ni l’orchestration. Il standardise l’échange entre une application compatible MCP et un serveur compatible MCP.
Le serveur MCP doit toujours relier ce contrat à une implémentation réelle : API, base de données, fichiers, moteur de recherche, workflow ou autre service.
EN PRATIQUE
MCP est une option de standardisation
Une solution peut orchestrer des outils définis directement dans l’application, exposés par une API classique ou accessibles via MCP. Le protocole devient particulièrement utile lorsque plusieurs applications doivent découvrir et appeler des capacités partagées. Il n’est ni un prérequis au RAG, ni une étape obligatoire avant de construire un workflow ou un agent.
Ce que vous allez apprendre
À la fin de ce chapitre, vous pourrez :
- expliquer les rôles de l’hôte MCP, du client MCP et du serveur MCP ;
- distinguer les primitives tools, resources et prompts ;
- décrire la découverte et l’appel de capacités à travers MCP ;
- comprendre la transition entre le lifecycle avec initialisation des révisions précédentes et le cœur stateless introduit par la révision
2026-07-28; - positionner MCP par rapport aux API, au RAG et à l’orchestration ;
- évaluer la valeur, les risques de sécurité et les besoins de gouvernance d’une adoption MCP.
Pourquoi introduire un protocole commun ?
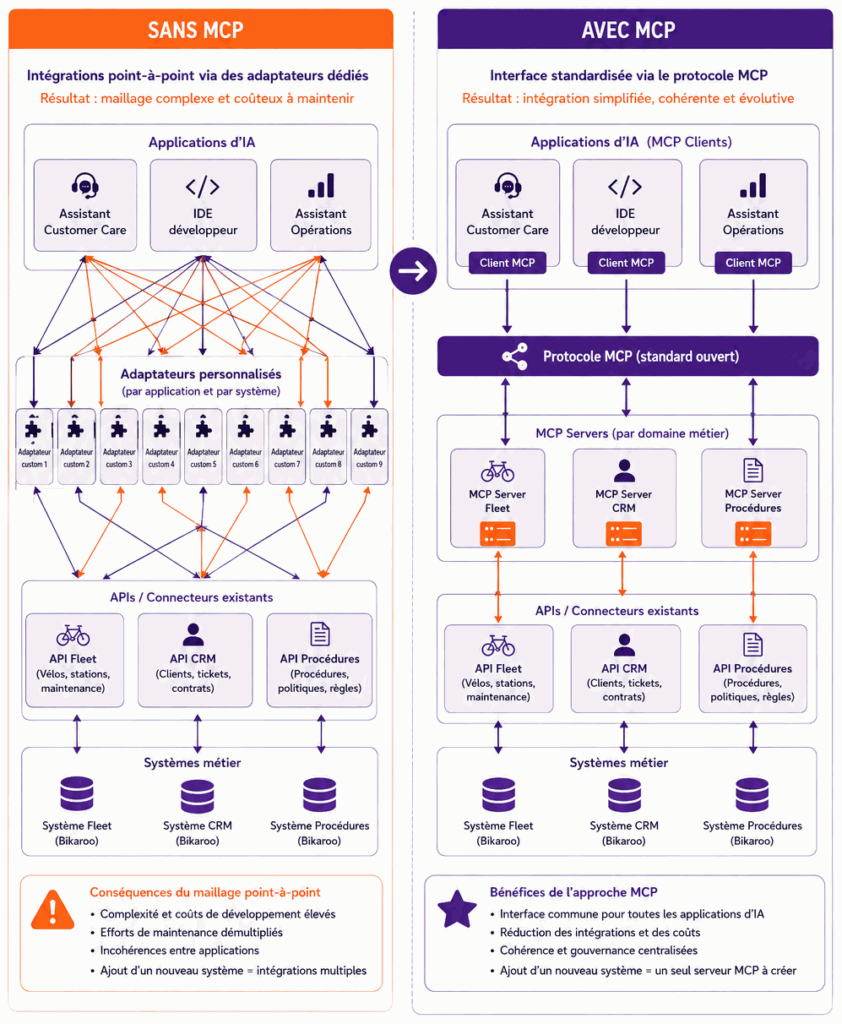
Le problème de la multiplication des intégrations
Supposons que Bikaroo dispose de quatre applications clientes et de cinq domaines de capacités.
4 clients × 5 domainesSans couche standardisée, chaque combinaison peut nécessiter une intégration spécifique.
Assistant Customer Care ──→ système de flotte
Assistant Customer Care ──→ CRM
Assistant Customer Care ──→ procédures

IDE développeur ───────────→ système de flotte
IDE développeur ───────────→ CRM
IDE développeur ───────────→ procédures

...
Cette multiplication entraîne :
- duplication du code d’intégration ;
- descriptions divergentes d’un même outil ;
- schémas incompatibles ;
- comportements d’erreur différents ;
- gouvernance fragmentée ;
- difficulté à remplacer une implémentation.
MCP introduit un contrat commun du côté des applications d’IA :
Application compatible MCP
        ↕
Protocole MCP
        ↕
Serveur MCP
Le serveur reste responsable d’adapter ce contrat à la réalité du domaine.
Ce que MCP standardise
MCP standardise la tuyauterie de l’échange : la manière d’identifier la révision du protocole utilisée, d’annoncer ou découvrir des capacités, de lister les primitives exposées, d’envoyer des appels et des réponses, de représenter les contenus et de signaler les erreurs. La spécification utilise JSON-RPC 2.0 pour encoder ces messages.
Les détails du lifecycle ne sont cependant pas immuables. Les révisions largement déployées jusqu’en 2025 s’appuient sur une phase d’initialisation et peuvent maintenir une session protocolaire. La révision 2026-07-28 simplifie ce fonctionnement en rendant le cœur du protocole stateless. Nous reviendrons sur cette transition plus loin dans le chapitre.
Ce que MCP ne standardise pas entièrement
En revanche, il laisse entière la partie difficile : la bonne granularité métier d’un outil, les transactions du système sous-jacent, la politique d’autorisation de l’entreprise, la façon de confirmer une action sensible, l’ordre d’un processus métier, la qualité des descriptions, la fiabilité d’un serveur tiers et la gouvernance du catalogue. Le protocole résout le comment échanger, pas le quoi exposer ni sous quel contrôle.
Le protocole réduit une partie de la friction d’intégration. Il ne supprime pas le travail d’architecture.
Comprendre les rôles de l’architecture MCP
La terminologie MCP distingue plusieurs niveaux.
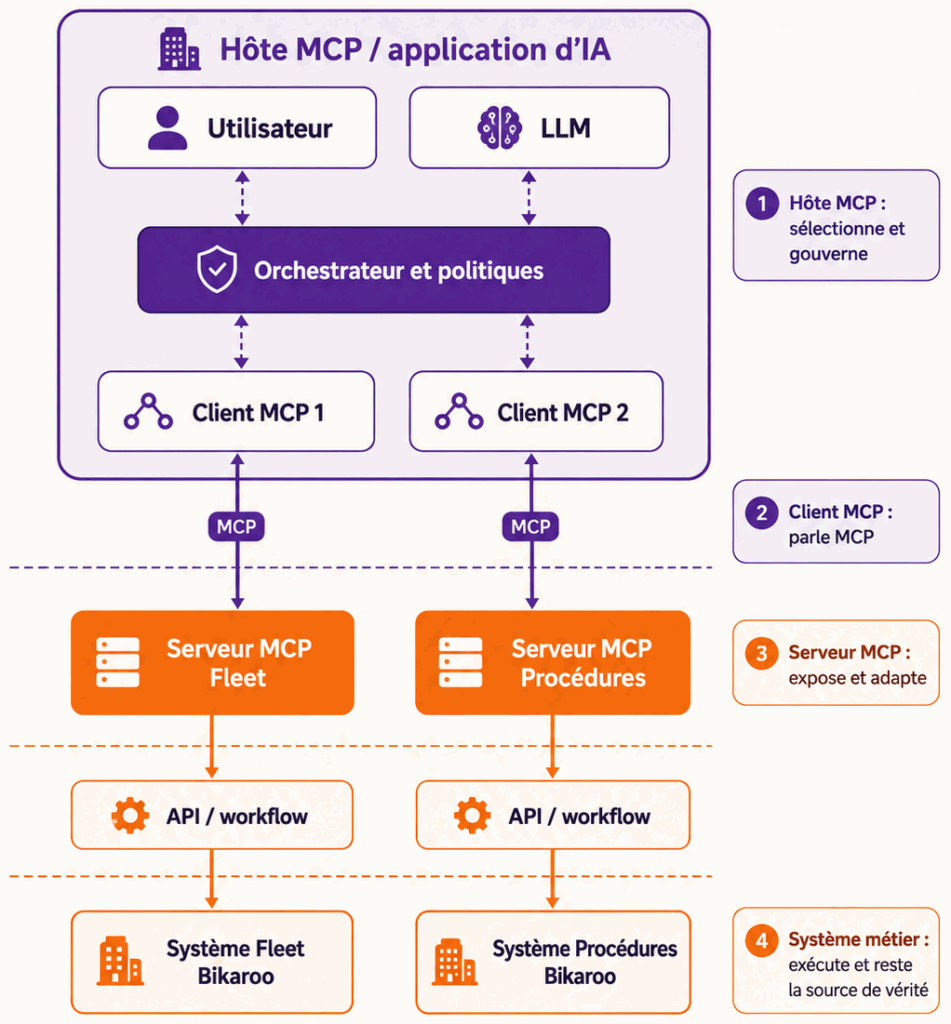
L’hôte MCP (host)
L’hôte MCP (host) est l’application complète dans laquelle l’expérience d’IA est exécutée.
Il peut s’agir :
- d’une application de chat ;
- d’un IDE ;
- d’un assistant métier ;
- d’une plateforme agentique ;
- d’un orchestrateur.
L’hôte :
- gère l’expérience utilisateur ;
- choisit les serveurs autorisés ;
- maintient la hiérarchie des instructions ;
- décide quelles capacités sont présentées au modèle ;
- applique les politiques locales ;
- coordonne les appels.
Le client MCP
Le client MCP est le composant de l’hôte chargé de communiquer avec un serveur MCP.
Hôte
├── Client MCP A ↔ Serveur MCP A
└── Client MCP B ↔ Serveur MCP B
Son travail est principalement protocolaire : il applique la révision MCP utilisée, fournit les métadonnées nécessaires, découvre les capacités lorsque cela est utile, envoie les requêtes et remet les résultats à l’hôte. Dans les révisions antérieures à 2026-07-28, ce rôle comprend aussi la phase initialize / initialized et, selon le transport, la gestion d’une session protocolaire.
Le client MCP n’est pas le LLM. Il appartient à l’application qui entoure le modèle.
Hôte, application et orchestrateur
Dans ce livre, application d’IA désigne le système global qui porte l’expérience utilisateur et les contrôles. Hôte MCP désigne le rôle que cette application joue lorsqu’elle utilise le protocole. L’orchestrateur est le composant — interne ou externe à cette application — qui coordonne les étapes d’un traitement.
Application d’IA / hôte MCP
├── expérience utilisateur et politiques
├── orchestrateur
└── clients MCP
Ces termes peuvent parfois désigner le même produit déployé, mais ils ne décrivent pas la même responsabilité.
Le serveur MCP
Le serveur MCP expose des primitives à travers le protocole.
Un serveur MCP présente une façade uniforme au-dessus de systèmes très différents. Il peut encapsuler :
- une API métier ;
- une base de données ;
- un moteur de recherche ;
- des fichiers ;
- un workflow ;
- un service SaaS ;
- un composant local ;
- un modèle spécialisé.
Exemple conceptuel :
Serveur MCP Fleet Bikaroo
├── tool: get_bike_status
├── tool: report_damaged_bike
├── resource: bikaroo://fleet/status-codes
└── prompt: investigate-damaged-bike
Le serveur traduit les appels MCP vers les implémentations réelles.
Une relation client–serveur, pas modèle–système
Le raccourci suivant est trompeur :
LLM ↔ serveur MCPLa chaîne réelle est plutôt :
LLM
  ↕
Hôte / orchestrateur
  ↕
Client MCP
  ↕
Serveur MCP
  ↕
API, workflow ou système métier
L’hôte reste l’endroit où les décisions d’exposition, de sélection et de contrôle sont prises.
Les trois primitives principales
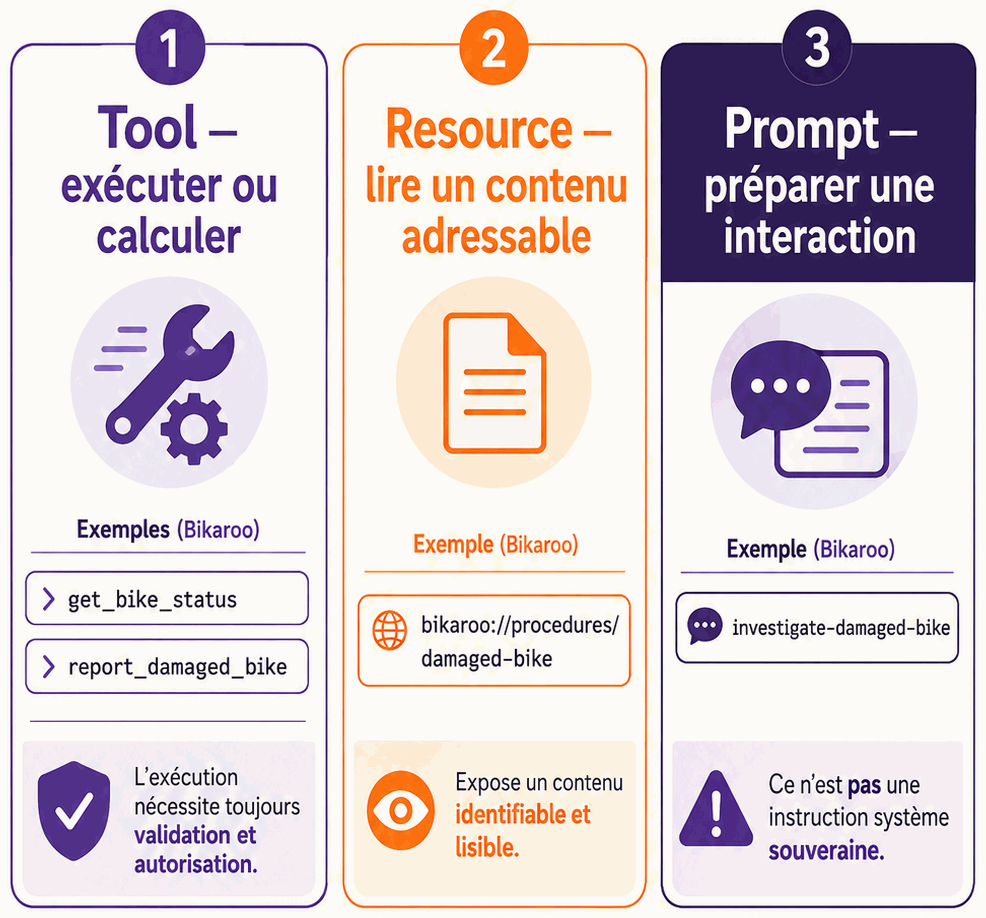
MCP distingue notamment trois primitives applicatives : tools, resources et prompts.
Elles ne répondent pas au même besoin.
- Tool — exécuter une opération ou un calcul. Contrôlé principalement par le modèle ou l’application, sous contrôle de l’hôte. Exemple :
get_bike_status. - Resource — lire un contenu adressable. Contrôlée principalement par l’application. Exemple :
bikaroo://procedures/damaged-bike. - Prompt — proposer un modèle de message réutilisable. Contrôlé principalement par l’utilisateur ou l’application. Exemple :
investigate-damaged-bike.
Les détails exacts de contrôle peuvent dépendre de l’implémentation. Le modèle mental important reste le suivant :
tool     → faire ou calculer
resource → lire un contenu
prompt   → préparer une interaction
Exposer des tools
Un tool représente une capacité que le serveur permet d’appeler.
Exemple :
{
  "name": "get_bike_status",
  "description": "Retourne le statut actuel d’un vélo Bikaroo.",
  "inputSchema": {
    "type": "object",
    "properties": {
      "bikeId": {
        "type": "string"
      }
    },
    "required": ["bikeId"]
  }
}
Le cycle conceptuel devient :
Serveur annonce le tool
        ↓
Hôte choisit de l’exposer au modèle
        ↓
LLM propose un appel
        ↓
Hôte valide et autorise
        ↓
Client MCP transmet l’appel
        ↓
Serveur exécute l’implémentation
        ↓
Résultat retourné à l’hôte
La présence d’un tool dans le catalogue ne signifie pas :
- qu’il est présenté au modèle ;
- que le modèle doit l’utiliser ;
- que l’utilisateur peut l’exécuter ;
- que ses arguments sont valides ;
- que son effet est acceptable.
Exposer des resources
Une resource représente un contenu adressable.
Exemples :
bikaroo://procedures/damaged-bike
bikaroo://fleet/status-codes
bikaroo://configuration/countries
Une resource peut contenir :
- du texte ;
- un fichier ;
- une configuration ;
- un schéma ;
- un rapport ;
- un résultat préparé.
La resource est adaptée lorsqu’une application veut accéder à un contenu identifié. Elle ne remplace pas une recherche sémantique sur un corpus.
Lire un document précis
→ resource

Retrouver les meilleurs passages parmi 20 000 documents
→ moteur de recherche ou RAG
Un serveur MCP peut néanmoins exposer un outil de recherche ou donner accès aux sources utilisées par un RAG.
Exposer des prompts
Un prompt MCP est un modèle de message ou de workflow conversationnel proposé par un serveur.
Exemple :
investigate-damaged-bikeIl peut préparer :
- un rôle ;
- des questions à poser ;
- une structure de réponse ;
- des arguments fournis par l’utilisateur ;
- des indications sur les ressources ou outils utiles.
Un prompt MCP ne doit pas être assimilé à une instruction système souveraine.
Prompt proposé par un serveur
        ≠
Politique de sécurité de l’hôte
L’hôte doit conserver la maîtrise de la hiérarchie des instructions.
Versions, capacités et découverte
MCP se trouve à une charnière importante de son évolution. Le modèle mental présenté jusqu’ici — hôte, client, serveur, primitives et contrôles — reste stable, mais le lifecycle protocolaire a fortement changé avec la révision 2026-07-28.
Deux fonctionnements vont coexister pendant la transition
La révision 2025-11-25 et plusieurs versions antérieures utilisent une phase initialize / initialized pour établir la compatibilité, échanger les capacités et éventuellement créer une session protocolaire. La révision 2026-07-28 retire cette poignée de main et la session du cœur du protocole : les requêtes deviennent autonomes et portent les informations nécessaires à leur traitement.
Dans une entreprise, les SDK, serveurs, produits, tutoriels et intégrations ne migrent pas tous le même jour. Vous pouvez donc encore rencontrer longtemps l’ancien fonctionnement. Un serveur qui attend initialize n’est pas nécessairement mal conçu : il peut simplement implémenter une révision antérieure du protocole.
Le contraste peut être résumé ainsi :
Révision 2025-11-25 | Révision 2026-07-28 | |
|---|---|---|
| Démarrage | initialize puis initialized | pas de handshake obligatoire |
| Version et capacités client | échangées à l’initialisation | fournies avec les requêtes |
| Session protocolaire HTTP | possible via Mcp-Session-Id | retirée du cœur du protocole |
| Découverte du serveur | capacités annoncées à l’initialisation | server/discover disponible lorsque nécessaire |
| Répartition HTTP | une session peut imposer de retrouver son contexte | une requête peut être traitée par n’importe quelle instance compatible |
Le modèle actuel : des requêtes autonomes
Dans la révision 2026-07-28, une requête n’a plus besoin d’être précédée par :
initialize
→ réponse d’initialisation
→ initialized
La version du protocole, les informations sur le client et ses capacités sont transportées avec les requêtes. Pour HTTP, la version apparaît notamment dans l’en-tête MCP-Protocol-Version.
Un client peut appeler server/discover lorsqu’il souhaite connaître à l’avance :
- les versions supportées par le serveur ;
- les capacités disponibles ;
- l’identité et la version du serveur ;
- les informations nécessaires avant d’effectuer d’autres appels.
Cette découverte initiale n’est pas toujours obligatoire. Un client peut également tenter directement une opération avec une version qu’il supporte et gérer une incompatibilité éventuelle.
Le fonctionnement historique : initialiser puis travailler dans la relation établie
Avec 2025-11-25, la séquence commence par une initialisation :
Client → initialize
Serveur → version et capacités supportées
Client → notification initialized
Cette phase sert à négocier une version compatible, échanger les informations d’implémentation et annoncer les familles de capacités disponibles. Avec Streamable HTTP, le serveur peut également attribuer un Mcp-Session-Id que le client renvoie ensuite sur les requêtes de la même session.
Ce lifecycle reste important à connaître, précisément parce qu’il existe déjà dans de nombreux serveurs et clients.
Compatibilité ne signifie pas uniformité
Un client ou un SDK moderne peut prévoir un chemin de compatibilité avec des serveurs plus anciens. La bonne stratégie n’est donc pas de supposer qu’un seul lifecycle existe, mais d’identifier la révision effectivement parlée par les deux côtés et d’appliquer les règles correspondantes.
Stateless au niveau MCP ne veut pas dire stateless au niveau métier
La suppression de la session protocolaire ne supprime ni la mémoire, ni l’état d’un workflow, ni l’état métier.
Bikaroo peut toujours avoir besoin de conserver :
caseId
tripId
basketId
workflowInstanceId
étape courante
validation humaine attendue
La différence est architecturale : cet état doit être explicite dans l’application, le workflow ou le système métier au lieu d’être supposé caché dans une session MCP.
MCP stateless
≠
application stateless
Une session technique n’est pas une source de vérité métier. Même lorsqu’une ancienne révision MCP maintient une session, l’état officiel du dossier doit rester dans les composants conçus pour le porter.
Capacités et découverte
Les capacités décrivent ce que chaque partie sait prendre en charge.
Un serveur peut par exemple exposer :
tools
resources
prompts
Selon la révision utilisée, ces informations sont obtenues lors de l’initialisation, via server/discover, ou à travers les mécanismes de découverte prévus par le protocole.
Le client peut ensuite demander les éléments exposés, par exemple :
tools/list
resources/list
prompts/list
Le serveur retourne des descriptions structurées.
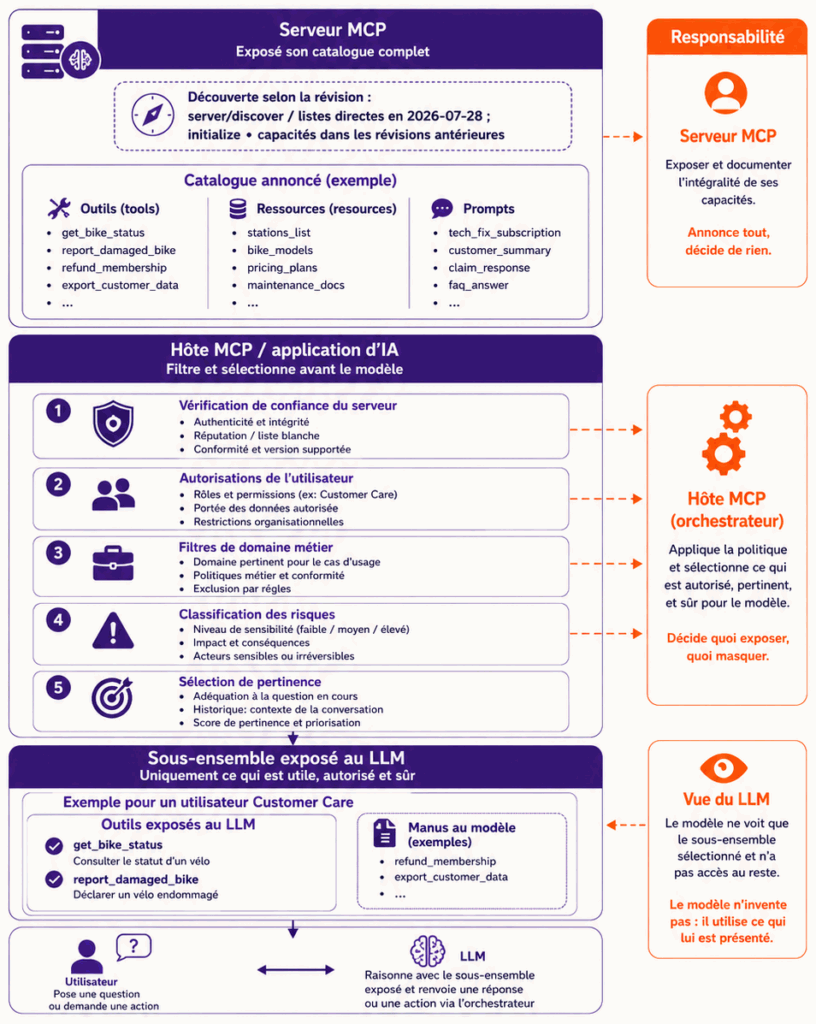
La découverte permet d’ajouter ou de modifier une capacité sans recopier manuellement sa définition dans chaque application. Elle ne supprime cependant pas le besoin de sélection.
Découvrir n’est pas tout exposer au modèle
Un serveur peut annoncer des centaines de tools. Les transmettre tous au LLM serait souvent une mauvaise idée :
- consommation du contexte ;
- confusion entre capacités proches ;
- augmentation du risque de mauvais choix ;
- élargissement inutile de la surface d’action ;
- descriptions potentiellement non fiables.
L’hôte doit appliquer :
découverte
→ validation du serveur et des métadonnées
→ filtrage par utilisateur et contexte
→ sélection d’un sous-ensemble
→ présentation éventuelle au modèle
La découverte est une capacité technique. La sélection reste une décision d’architecture et de sécurité.
Comprendre les transports
MCP encode les messages en JSON-RPC et définit des mécanismes de transport standard.
Les deux transports que l’on rencontre principalement dans le cadre de ce chapitre sont :
stdio
Streamable HTTP
Le transport et le lifecycle sont deux sujets distincts. Streamable HTTP existe dans les deux générations décrites ci-dessus, mais son usage n’est pas identique : les révisions antérieures peuvent s’appuyer sur une session protocolaire, tandis que 2026-07-28 utilise des requêtes autonomes au niveau MCP.
stdio
Avec stdio, l’hôte lance généralement un serveur local comme sous-processus.
Hôte
  ↕ entrée/sortie standard
Serveur MCP local
Ce mode est utile pour :
- un outil local ;
- un environnement de développement ;
- une intégration sur la même machine ;
- un processus dont le cycle de vie est contrôlé par l’hôte.
Les secrets nécessaires sont alors généralement fournis par l’environnement ou par un mécanisme local approprié, et non par le flux OAuth destiné aux serveurs HTTP distants.
Streamable HTTP
Avec Streamable HTTP, le serveur est accessible par HTTP.
Hôte
  ↕ HTTPS
Serveur MCP distant
Dans la révision 2026-07-28, chaque requête MCP transporte les informations protocolaires nécessaires à son traitement et n’est plus liée à un Mcp-Session-Id. Cela facilite notamment la répartition des appels entre plusieurs instances du serveur.
Avec 2025-11-25 et des révisions antérieures, vous pouvez encore rencontrer un serveur qui crée une session lors de l’initialisation et demande au client de renvoyer son identifiant sur les appels suivants.
Dans les deux cas, Streamable HTTP convient notamment à :
- des serveurs mutualisés ;
- des capacités d’entreprise ;
- des services déployés à distance ;
- des environnements nécessitant une autorisation déléguée.
Le transport ne définit pas l’architecture métier
Le transport répond à la question :
Comment les messages MCP circulent-ils ?
Il ne répond pas à :
- qui a le droit d’utiliser l’outil ;
- quelles données sont visibles ;
- si l’action nécessite une confirmation ;
- quelle transaction doit être exécutée ;
- comment le processus est orchestré.
Positionner MCP par rapport aux API et à OpenAPI
MCP et API métier
Une API expose généralement une interface vers un système ou un domaine.
GET /fleet/bikes/{bikeId}/status
POST /fleet/bikes/{bikeId}/damage-reports
Un serveur MCP peut encapsuler ces interfaces sous forme de capacités adaptées à une application d’IA :
get_bike_status
report_damaged_bike
La chaîne devient :
Hôte et client MCP
        ↓
Serveur MCP
        ↓
API métier
        ↓
Système de flotte
MCP ne rend pas l’API inutile. Il ajoute une couche d’exposition destinée aux clients compatibles MCP.
MCP et OpenAPI
OpenAPI décrit principalement des API HTTP :
- chemins ;
- méthodes ;
- paramètres ;
- payloads ;
- réponses ;
- codes d’erreur.
MCP décrit une interaction entre applications d’IA et serveurs de contexte ou de capacités.
ERREUR
Une description OpenAPI peut aider à générer des tools, mais une transformation automatique produit souvent une interface trop technique.
47 opérations REST
        ↓ adaptation métier
5 tools compréhensibles et contrôlables
Exposer une API existante n’est pas la reproduire telle quelle. L’adapter au modèle demande de la remodeler — regrouper plusieurs appels, simplifier les paramètres, renommer les opérations, masquer les détails techniques — et de la sécuriser — ajouter des validations, traduire les erreurs, définir des politiques de confirmation.
MCP n’est pas une couche d’orchestration
Un serveur MCP expose une capacité. Il ne définit pas nécessairement :
- l’ordre de plusieurs appels ;
- les conditions de branchement ;
- la compensation d’une transaction ;
- le moment d’une validation humaine ;
- la condition d’arrêt d’une mission.
Ces responsabilités appartiennent à l’application, à un moteur de workflow, à un orchestrateur ou, dans certains cas, à un agent. Elles seront étudiées dans les chapitres suivants.
Sécuriser une architecture MCP
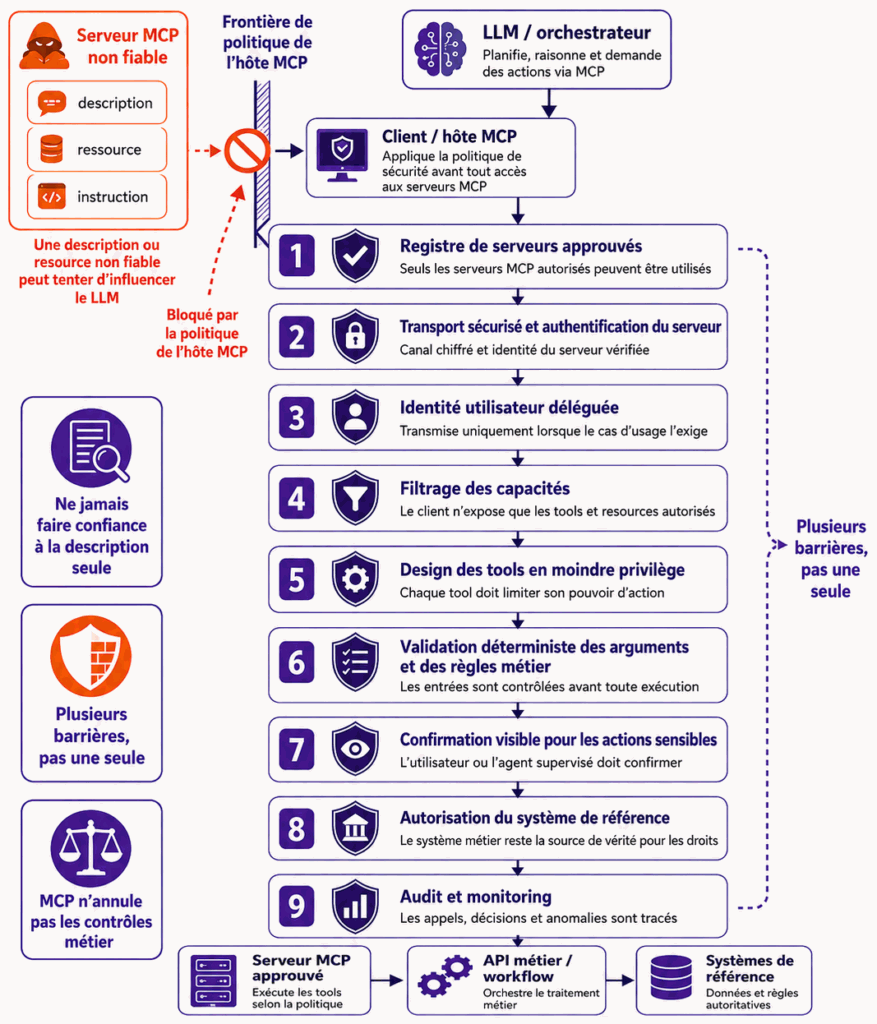
Sécuriser une architecture MCP ne consiste pas seulement à protéger le transport ou à authentifier un serveur. Ces contrôles sont nécessaires, mais ils ne suffisent pas. Le risque porte aussi sur les capacités annoncées, les descriptions fournies au modèle, les resources lues, les prompts proposés et les tools que l’hôte décide d’exposer.
Autrement dit, MCP ajoute une couche de standardisation, mais il ajoute aussi une surface de gouvernance : l’hôte doit choisir les serveurs autorisés, filtrer les capacités, appliquer les politiques locales et refuser ce qui ne correspond pas au contexte, au rôle de l’utilisateur ou au niveau de risque.
MCP facilite la connexion à des capacités puissantes. Cette facilité augmente aussi la surface de risque.
Authentification et autorisation du transport
Pour les transports HTTP protégés, la spécification MCP définit un cadre d’autorisation fondé sur les standards OAuth.
De manière simplifiée :
Utilisateur ou organisation
        ↓ consentement / politique
Client MCP
        ↓ jeton d’accès
Serveur MCP protégé
Cette couche répond notamment à :
- quel client appelle le serveur ;
- au nom de quel utilisateur ou propriétaire de ressource ;
- avec quel jeton ;
- pour quelle ressource protégée.
L’autorisation MCP est optionnelle au niveau du protocole. Lorsqu’un serveur HTTP distant expose des capacités sensibles, une architecture d’entreprise doit néanmoins mettre en place une authentification et une autorisation adaptées.
Pour stdio, le modèle de sécurité est différent : le serveur est local et les secrets sont généralement obtenus depuis l’environnement contrôlé.
L’autorisation du protocole ne remplace pas les règles métier
Un jeton valide ne prouve pas que l’action demandée est acceptable.
Jeton valide
        ≠
Droit de rembourser n’importe quel client
Le serveur et les systèmes métier doivent encore vérifier :
- le rôle de l’utilisateur ;
- le périmètre géographique ;
- le droit sur la donnée ou l’objet ;
- le montant autorisé ;
- l’état actuel de la ressource ;
- les règles de séparation des fonctions ;
- les confirmations ou approbations nécessaires.
Le problème du confused deputy
Un serveur ne doit pas utiliser ses propres privilèges de manière aveugle pour exécuter une demande faite au nom d’un utilisateur moins privilégié.
Il faut préserver et contrôler le contexte d’identité :
identité du client
+
identité de l’utilisateur
+
capacité demandée
+
objet concerné
+
politique métier
Sécurité des descriptions et du contenu
Les descriptions de tools, les resources et les résultats viennent d’un serveur externe à l’hôte. Ils ne doivent pas être considérés comme des instructions souveraines.
Un serveur malveillant ou compromis peut tenter :
- d’insérer des instructions dans une description de tool ;
- d’inciter le modèle à appeler un autre outil ;
- de demander l’exfiltration de données ;
- de masquer l’effet réel d’une opération ;
- de renvoyer un contenu trompeur.
L’hôte doit traiter ces éléments comme du contenu non fiable et appliquer des contrôles indépendants du LLM.
Minimiser le pouvoir des tools
Un tool comme :
execute_arbitrary_sqlest beaucoup plus risqué que :
get_bike_statusUne bonne conception va toujours dans le même sens : réduire ce qu’un outil peut faire et rendre visible ce qu’il fait. Cela passe par un périmètre étroit — capacités métier restreintes, schémas restrictifs, moindre privilège, séparation lecture/écriture ; et par un contrôle déterministe — limites de volume, validation hors du modèle, confirmation visible pour les effets sensibles, audit complet.
Faire apparaître l’action à l’utilisateur
Pour une action sensible, l’utilisateur devrait pouvoir voir :
outil appelé
cible
arguments essentiels
effet attendu
identité utilisée
avant de confirmer.
La transparence réduit le risque qu’une description trompeuse ou une interprétation erronée mène à une action silencieuse.
Gouverner les serveurs et le catalogue
Établir une liste de confiance
Une entreprise ne devrait pas permettre à ses hosts de se connecter arbitrairement à n’importe quel serveur MCP.
Un serveur MCP est une porte d’entrée vers des systèmes réels ; l’entreprise doit donc savoir lesquels elle a ouverts. Elle peut maintenir :
- un registre de serveurs approuvés ;
- un propriétaire par serveur ;
- une classification des données ;
- une revue de sécurité ;
- des versions supportées ;
- des empreintes ou mécanismes de vérification ;
- des environnements autorisés.
Gouverner chaque capacité
Pour chaque tool, resource ou prompt, il faut connaître :
nom et version
propriétaire
description
domaine
niveau de risque
données manipulées
rôles autorisés
systèmes appelés
politique de confirmation
journalisation
cycle de vie
Choisir la granularité des serveurs
Deux stratégies extrêmes sont possibles.
Un serveur par système technique
mcp-sap
mcp-salesforce
mcp-servicenow
Cette approche suit l’organisation technique, mais peut exposer des opérations trop proches des API sous-jacentes.
Un serveur par domaine métier
mcp-fleet
mcp-customer-care
mcp-memberships
Cette approche peut offrir des capacités plus compréhensibles, mais demande une gouvernance de domaine et peut orchestrer plusieurs systèmes.
Le bon choix dépend :
- des responsabilités ;
- des frontières de sécurité ;
- du cycle de vie ;
- de l’équipe propriétaire ;
- des données ;
- de la cohérence métier.
Il n’existe pas de règle universelle imposant un serveur par application ou par système.
Versionner sans surprendre les clients
Modifier silencieusement :
- le sens d’un tool ;
- ses paramètres ;
- son effet ;
- son niveau de risque ;
- le format de son résultat
peut casser les clients ou produire des actions inattendues.
Les changements doivent être :
- compatibles lorsque possible ;
- versionnés ;
- testés ;
- annoncés ;
- observables.
Scénario complet — Le serveur MCP Fleet Bikaroo
Capacités exposées
Le serveur du domaine Fleet expose :
tools
├── get_bike_status
└── report_damaged_bike

resources
├── bikaroo://fleet/status-codes
└── bikaroo://procedures/damaged-bike

prompts
└── investigate-damaged-bike
Compatibilité de version et découverte
Dans une implémentation ciblant 2026-07-28, le client peut d’abord utiliser server/discover s’il souhaite connaître les versions et capacités du serveur avant l’appel métier.
Client MCP
→ découvre la version et les capacités si nécessaire
→ utilise la révision compatible
→ liste les capacités utiles
S’il rencontre un serveur plus ancien qui ne connaît pas ce mécanisme, un client conçu pour la compatibilité peut retomber sur le lifecycle historique :
Client MCP
→ initialize
→ négociation de version et de capacités
→ initialized
→ listes et appels
L’hôte sait alors quelles capacités le serveur expose, quelle que soit la génération de protocole utilisée.
Sélection locale
Marie est autorisée à consulter et à signaler un vélo, mais pas à effectuer des opérations financières.
L’hôte expose au LLM :
get_bike_status
report_damaged_bike
Les autres capacités découvertes ne sont pas présentées.
Demande de l’utilisateur
prompt
Le vélo VL-2048 a la roue arrière bloquée. Peux-tu le signaler ?
Appel proposé par le modèle
{
  "name": "report_damaged_bike",
  "arguments": {
    "bikeId": "VL-2048",
    "issue": "rear_wheel_blocked"
  }
}
Contrôles de l’hôte
L’hôte vérifie :
- que le tool provient d’un serveur approuvé ;
- que Marie peut l’utiliser ;
- que les arguments sont conformes ;
- que le vélo existe ;
- que l’effet est clairement présenté ;
- qu’une confirmation est obtenue si nécessaire.
Exécution par le serveur
Client MCP
→ tools/call
→ Serveur MCP Fleet
→ API métier
→ Système de flotte
Le serveur transmet le contexte d’identité approprié et le système métier applique ses propres règles.
Résultat
{
  "bikeId": "VL-2048",
  "status": "unavailable",
  "reportId": "DR-8492",
  "recordedAt": "2026-07-01T15:42:00+02:00"
}
L’hôte peut réinjecter un résultat réduit et contrôlé dans le contexte du LLM.
response
Le vélo VL-2048 a été signalé comme endommagé et rendu indisponible. Référence : DR-8492.
MCP a standardisé l’échange. Les validations, l’autorisation métier et la transaction sont restées sous la responsabilité des couches appropriées.
Quand MCP apporte-t-il une vraie valeur ?
MCP est particulièrement utile lorsque :
- plusieurs hosts doivent consommer les mêmes capacités ;
- les capacités doivent être découvertes de manière standardisée ;
- plusieurs technologies clientes doivent interopérer ;
- l’on souhaite remplacer une implémentation sans réécrire chaque client ;
- des outils locaux et distants doivent partager un modèle d’interaction ;
- un écosystème de serveurs réutilisables doit être gouverné.
MCP apporte moins de valeur lorsque :
- une seule application appelle une seule API stable ;
- aucun autre client n’utilisera la capacité ;
- la couche supplémentaire complexifie davantage qu’elle ne standardise ;
- les capacités ne sont pas destinées à des applications d’IA ;
- l’intégration existante est déjà simple, sûre et bien gouvernée.
La question n’est donc pas :
MCP est-il moderne ?
mais :
Existe-t-il un problème réel d’interopérabilité, de découverte ou de réutilisation que MCP résout mieux qu’une intégration directe ?
MCP évolue rapidement. Ce chapitre assume donc deux niveaux de lecture : le modèle mental durable — hôte, client, serveur, primitives et contrôles — et un focus daté sur la transition 2025-11-25 → 2026-07-28. Le lecteur peut ainsi comprendre la cible actuelle sans considérer comme « faux » un serveur, un SDK ou un tutoriel encore fondé sur le lifecycle précédent.
En résumé
- MCP est un protocole ouvert pour connecter des applications d’IA à des capacités et contenus externes.
- L’hôte MCP porte l’expérience et les politiques ; il peut contenir ou appeler un orchestrateur.
- Le client MCP assure les échanges protocolaires avec un serveur selon la révision utilisée.
- Le serveur MCP expose et adapte des capacités vers des implémentations réelles.
- Les trois primitives principales sont les tools, resources et prompts.
- MCP utilise JSON-RPC et définit notamment les transports
stdioet Streamable HTTP. - La révision
2026-07-28retire le handshakeinitialize/initializedet la session protocolaire du cœur MCP ; les révisions précédentes peuvent encore les utiliser. - Un protocole MCP stateless n’impose pas une application stateless : l’état métier et l’état de processus restent explicites ailleurs.
- La découverte ne signifie ni confiance, ni autorisation, ni exposition automatique au LLM.
- MCP ne remplace pas les API, le RAG, les systèmes métier ou l’orchestration.
- OAuth peut sécuriser l’accès à un serveur HTTP, mais ne remplace pas les règles métier ni les contrôles d’intention.
- Les descriptions et résultats provenant des serveurs doivent être traités comme du contenu non fiable.
- La valeur de MCP apparaît surtout lorsque plusieurs applications doivent réutiliser un écosystème de capacités.
- Pendant la transition, un client peut devoir comprendre à la fois le lifecycle
2026-07-28et le lifecycle historique fondé surinitialize. - Les détails de lifecycle et de transport peuvent évoluer selon la révision ; le modèle mental des responsabilités reste stable.
MCP permet de découvrir et d’appeler des capacités de manière standardisée. Mais il ne dit pas dans quel ordre les utiliser, quand suspendre un traitement, quand demander une confirmation, comment reprendre après erreur ni comment coordonner plusieurs étapes autour d’un état fiable.
Dès qu’une demande combine procédure, données opérationnelles, décisions métier, actions sensibles et validations humaines, une autre brique devient nécessaire : l’orchestration.
Vérifiez votre compréhension
Question 1 — Quelle différence existe entre un hôte MCP et un client MCP ?
Réponse : L’hôte est l’application globale qui choisit les serveurs, applique les politiques et coordonne l’expérience. Le client MCP est le composant qui maintient une relation protocolaire avec un serveur.
Question 2 — Pourquoi le raccourci « le LLM appelle directement le serveur MCP » est-il trompeur ?
Réponse : Le LLM propose éventuellement une action, mais l’hôte valide la décision et le client MCP transmet l’appel au serveur.
Question 3 — Quand utiliser un tool, une resource ou un prompt ?
Réponse : Un tool sert à faire ou calculer, une resource à lire un contenu adressable, et un prompt à proposer un modèle d’interaction réutilisable.
Question 4 — Pourquoi ne faut-il pas transmettre au modèle tous les tools découverts ?
Réponse : Certains sont inutiles, trop puissants ou non autorisés. Un sous-ensemble réduit améliore la sécurité, la compréhension et le coût.
Question 5 — Quelle différence existe entre MCP et une API REST ?
Réponse : REST expose des ressources ou opérations techniques entre systèmes ; MCP standardise la découverte et l’appel de capacités du point de vue d’une application d’IA. Un serveur MCP peut s’appuyer sur une API REST.
Question 6 — Que protège l’autorisation OAuth d’un serveur MCP, et que ne protège-t-elle pas ?
Réponse : Elle contrôle l’accès au serveur et aux scopes techniques. Elle ne remplace pas les règles métier, les validations des arguments ni les confirmations d’une action sensible.
Question 7 — Pourquoi un serveur MCP approuvé peut-il malgré tout exposer un tool trop puissant ?
Réponse : La confiance dans le serveur ne garantit pas que chaque capacité soit correctement granularisée, autorisée ou adaptée au contexte de l’utilisateur.
Question 8 — Dans quel cas une intégration directe peut-elle rester préférable à MCP ?
Réponse : Pour une capacité unique, stable, étroitement intégrée à une seule application, lorsqu’une couche protocolaire supplémentaire n’apporte pas de bénéfice mesurable.
Question 9 — Pourquoi peut-on encore rencontrer initialize et Mcp-Session-Id alors que la révision 2026-07-28 les retire du cœur du protocole ?
Réponse : Parce que les serveurs, SDK et produits existants ne migrent pas tous immédiatement. Ces mécanismes restent caractéristiques de 2025-11-25 et de révisions antérieures qu’un environnement réel peut encore utiliser.
Question 10 — Que signifie « MCP est stateless » dans la révision 2026-07-28 ?
Réponse : Cela signifie que le protocole ne dépend plus d’une session cachée pour relier les requêtes. L’application peut néanmoins conserver un état métier ou de processus explicite dans un workflow, une base ou un système de référence.
Transition vers le chapitre suivant
Nous savons maintenant comment une application peut découvrir et appeler des capacités à travers un contrat standardisé. MCP facilite l’exposition et la réutilisation des tools, resources et prompts, mais il ne transforme pas automatiquement ces capacités en processus fiable.
MCP ne décide pas encore :
- dans quel ordre appeler plusieurs tools ;
- comment brancher le processus selon un résultat ;
- comment gérer une reprise ou une compensation ;
- quand demander une intervention humaine ;
- quand considérer le travail comme terminé.
Ces responsabilités nous conduisent au chapitre suivant :
Chapitre 8 — Peux-tu clôturer mon trajet et vérifier les frais ?
Orchestration, workflow et contrôle du processus