Ouvrir le capot de l’IA
Pourquoi la réponse était-elle fausse ?
Évaluation, observabilité et audit
Introduction — Une bonne réponse au mauvais document
Marie : L’assistant a répondu avec assurance qu’un trajet resté ouvert pouvait être régularisé dans les vingt-quatre heures. Pourtant, la procédure actuelle ne prévoit plus ce délai.
Assistant Bikaroo : J’ai correctement résumé le passage qui m’a été fourni. Ce passage provenait cependant d’une ancienne version de la procédure.
La réponse est fausse. La première réaction pourrait être :
Le LLM s'est trompé.Mais cette conclusion serait trop rapide.
Le modèle a peut-être reçu une mauvaise source. Le moteur de recherche a peut-être ignoré le statut du document. Les métadonnées ont peut-être disparu lors de l’indexation. Le corpus a peut-être conservé une procédure archivée. Le prompt a peut-être demandé une réponse même lorsque les sources se contredisaient.
Une réponse générée est le résultat d’une chaîne :
demande
→ contexte
→ retrieval
→ sources
→ modèle
→ tools éventuels
→ règles et validations
→ réponse
Diagnostiquer une erreur consiste à remonter cette chaîne sans accuser arbitrairement la dernière brique visible.
Dans ce chapitre, nous allons mener l’enquête sur la réponse des « vingt-quatre heures ». Cette enquête servira de fil conducteur pour comprendre trois activités différentes :
évaluer
→ déterminer si le résultat est acceptable

observer
→ comprendre ce qui s'est passé pendant l'exécution

auditer
→ reconstruire et justifier les décisions importantes
Le but n’est pas de vous transformer en spécialiste des métriques, mais de vous donner une méthode reproductible pour répondre à une question beaucoup plus utile :
Quelle couche faut-il réellement corriger ?
Ce que vous allez apprendre
À la fin de ce chapitre, vous pourrez :
- partir d’un symptôme métier et formuler des hypothèses de diagnostic ;
- distinguer évaluation, observabilité et audit ;
- localiser une erreur dans le retrieval, les sources, la génération, les tools ou le workflow ;
- construire des traces et des critères de succès adaptés au risque ;
- transformer un incident en correction ciblée, test de non-régression et surveillance durable.
Partir du symptôme, pas de la métrique
Marie ne commence pas son enquête avec un tableau de bord. Elle commence avec un écart entre la réponse du système et la procédure actuelle.
Réponse observée :
« Le trajet peut être régularisé dans les vingt-quatre heures. »

Règle actuelle :
aucun délai de vingt-quatre heures n'est prévu.
Le premier travail consiste à décrire précisément le symptôme.
Décrire ce qui est incorrect
Une réponse peut être problématique de plusieurs manières :
- elle affirme un fait faux ;
- elle utilise une source obsolète ;
- elle omet une exception importante ;
- elle présente une hypothèse comme une certitude ;
- elle respecte le fond mais pas le format attendu ;
- elle est correcte mais trop lente ou trop coûteuse ;
- elle révèle une donnée que l’utilisateur ne devrait pas voir ;
- elle propose ou exécute une action interdite.
Dans le cas de Marie, le problème n’est ni le ton, ni la grammaire, ni le format. C’est une erreur métier liée à la validité temporelle de la source.
Cette précision est importante. Une métrique de style ou de satisfaction ne permettra pas de trouver la cause.
Formuler des hypothèses avant de modifier le système
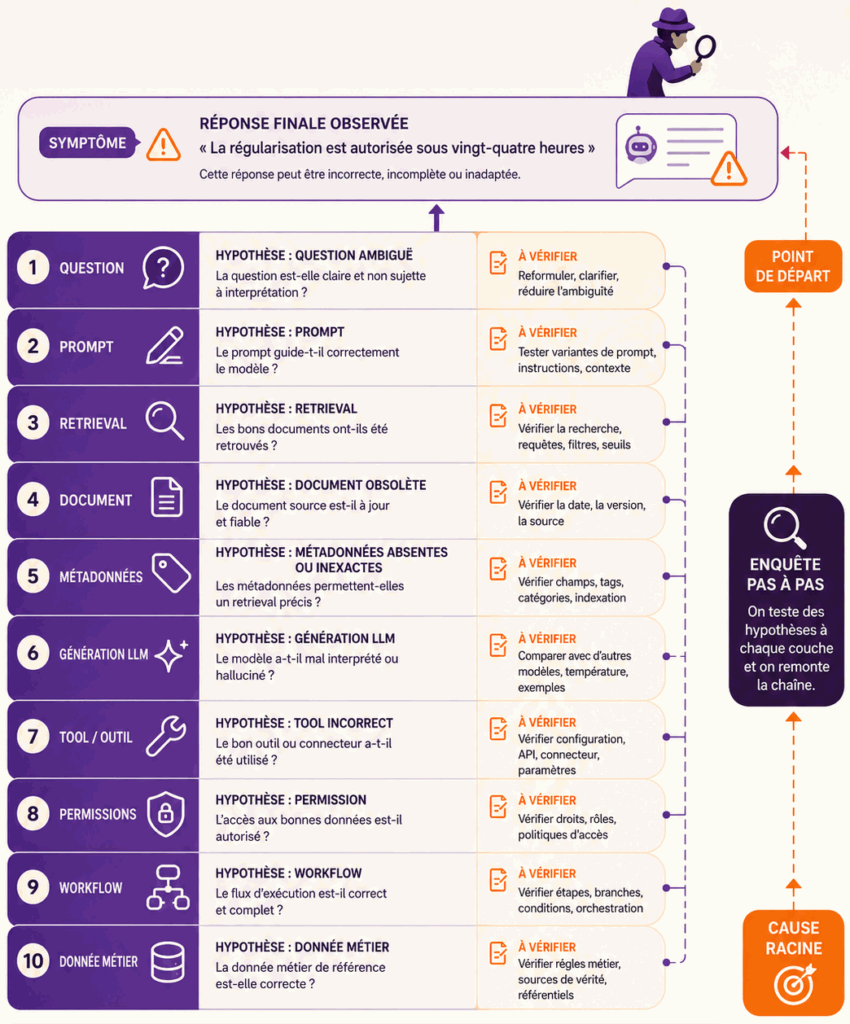
Plusieurs hypothèses peuvent expliquer la même réponse :
H1 — La question de Marie était ambiguë.
H2 — Le prompt demandait de répondre malgré une incertitude.
H3 — Le retrieval a retrouvé une ancienne procédure.
H4 — Les métadonnées de version étaient absentes.
H5 — Le LLM a inventé le délai.
H6 — Un tool a retourné une ancienne règle.
H7 — La règle actuelle n'était pas encore publiée dans le corpus.
Ces hypothèses ne sont pas équivalentes. Elles ne conduisent ni aux mêmes contrôles, ni aux mêmes corrections.
Modifier immédiatement le modèle ou le prompt peut masquer le problème réel. Si l’ancienne procédure reste indexée, l’erreur réapparaîtra sous une autre formulation.
La méthode de diagnostic sera donc :
symptôme
→ hypothèses
→ preuves disponibles
→ couche fautive
→ correction
→ test de non-régression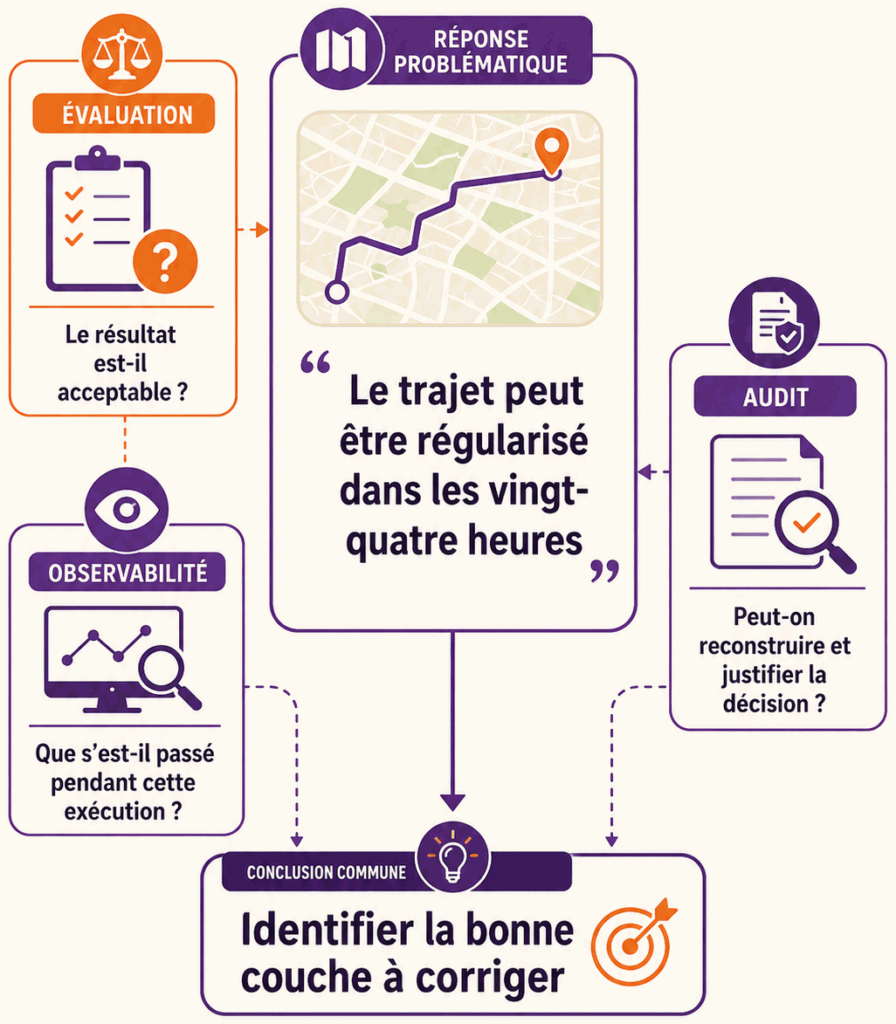
Définir ce que signifie réussir
Avant d’évaluer le système, Bikaroo doit décider ce qu’une réponse acceptable signifie pour ce cas d’usage.
Une réponse fluide n’est pas nécessairement correcte. Une réponse correcte peut être impossible à justifier. Une réponse utile peut arriver trop tard. Une réponse exacte à 90 % peut rester inacceptable si les 10 % d’erreurs concernent les remboursements, les données personnelles ou les actions irréversibles.
Évaluation, observabilité et audit
Ces trois regards répondent à des questions différentes.
Évaluation
Le système fait-il correctement ce qu'on attend ?Dans notre enquête : la réponse est-elle conforme à la procédure active ?
Observabilité
Que s'est-il passé pendant cette exécution ?Dans notre enquête : quelle requête de recherche a été utilisée, quels passages ont été retrouvés et quelle version du prompt a été envoyée au modèle ?
Audit
Peut-on reconstruire et justifier la décision ?Dans notre enquête : peut-on prouver quelle procédure a été utilisée, qui l’a publiée, quand elle a été indexée et pourquoi elle était encore considérée comme active ?
Une évaluation sans observabilité détecte l’erreur, mais ne l’explique pas. Une observabilité sans critères de succès produit beaucoup de traces, mais ne dit pas si le résultat est acceptable. Un audit sans données fiables ne peut pas justifier la décision.
Le découpage entre évaluation, observabilité et audit n’est pas propre à Bikaroo. Le NIST AI Risk Management Framework organise la gestion des risques d’un système d’IA en quatre fonctions — govern, map, measure et manage. Les deux dernières recouvrent l’essentiel de ce que nous appelons ici évaluer et observer : measure rassemble les critères, les tests et les métriques ; manage couvre le traitement des écarts et la surveillance dans la durée.
La correspondance n’est pas terme à terme, et le découpage retenu dans ce chapitre suit l’enquête plutôt que le cadre. Ce qu’il faut en retenir est le point de méthode : mesurer et surveiller y sont des activités continues, pas une étape de recette franchie une fois avant la mise en production.
Définir des critères liés au risque
Pour l’assistant documentaire de Marie, le succès pourrait être défini ainsi :
réponse conforme à la procédure active
+ source visible et accessible
+ aucune information non supportée
+ abstention si les sources sont insuffisantes ou contradictoires
+ réponse en moins de 5 secondes
Mais tous les critères n’ont pas la même importance.
réponse un peu trop longue
→ défaut de confort

ancienne procédure appliquée
→ risque métier

information d'un autre membre affichée
→ incident de confidentialité
Il faut donc distinguer :
- la fréquence d’une erreur ;
- sa gravité ;
- sa détectabilité ;
- sa réversibilité ;
- le nombre d’utilisateurs exposés.
ERREUR
Un système peut afficher un bon score moyen tout en échouant sur les cas les plus sensibles.
Construire un jeu de tests utile
Un jeu de tests ne doit pas seulement contenir des questions faciles. Il doit représenter les usages réels et les risques importants.
Pour Bikaroo, on peut inclure :
questions fréquentes
→ « Que faire si un trajet reste ouvert ? »

paraphrases
→ « Ma course ne s'est pas clôturée. Quelle est la procédure ? »

versions temporelles
→ ancienne et nouvelle procédure

contradictions
→ deux documents donnant des règles différentes

absence de réponse
→ sujet non couvert par le corpus

permissions
→ document réservé à Finance

attaques
→ instruction malveillante cachée dans un document

erreurs de tools
→ timeout ou statut incomplet
Chaque cas devrait préciser :
entrée
contexte ou état initial
sources attendues
réponse acceptable
réponse interdite
comportement d'abstention attendu
actions autorisées ou interdites
EN PRATIQUE
L’incident des « vingt-quatre heures » doit devenir un cas permanent du jeu de tests. Il ne s’agit plus seulement de corriger l’erreur actuelle, mais d’empêcher sa réapparition.
Remonter la chaîne de la réponse
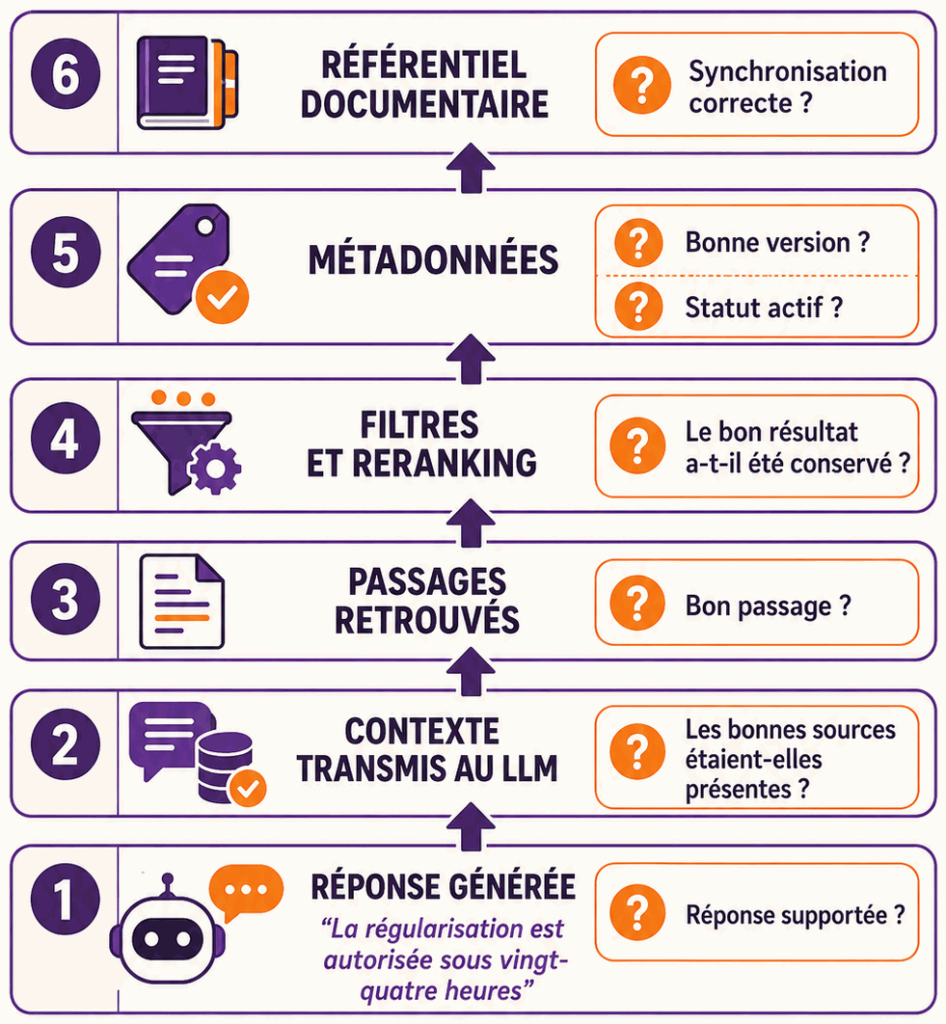
Nous pouvons maintenant examiner les couches dans l’ordre inverse de leur visibilité. La réponse finale est visible. Les causes possibles se trouvent en amont.
Étape 1 — La réponse est-elle supportée par ce que le modèle a reçu ?
La première question ne consiste pas encore à vérifier si la réponse est vraie dans le monde réel. Elle consiste à comparer la réponse avec le contexte fourni au modèle.
Passage transmis :
Une demande de régularisation peut être introduite dans les vingt-quatre heures.Réponse :
La procédure permet une régularisation dans les vingt-quatre heures.Le modèle a correctement résumé le passage.
On parle de groundedness lorsque la réponse est fondée sur les sources fournies.
Mais la groundedness n’est pas la vérité.
réponse fidèle
+
source obsolète
=
réponse métier fausse
Cette distinction évite un mauvais diagnostic : le modèle n’a pas nécessairement halluciné. Il a peut-être utilisé fidèlement une information qui n’aurait jamais dû entrer dans son contexte.
Étape 2 — Le bon passage a-t-il été retrouvé ?
Le RAG comporte au moins deux problèmes distincts :
retrieval
→ retrouver les bons passages

génération
→ produire une réponse fidèle à ces passages
Dans notre enquête, la génération semble correcte. Il faut donc examiner le retrieval.
Questions à poser :
- la procédure active apparaît-elle dans les résultats ?
- à quel rang ?
- l’ancienne procédure apparaît-elle aussi ?
- les filtres de langue, pays, statut et date ont-ils été appliqués ?
- les scores de similarité sont-ils proches ?
- un reranking a-t-il favorisé le mauvais document ?
Trace simplifiée :
1. PROC-TRIP-OPEN v3.8 — score 0,89
2. PROC-TRIP-OPEN v4.1 — score 0,86
Le moteur a retrouvé deux passages très proches. L’ancienne version est arrivée en premier.
Ce résultat n’est pas absurde du point de vue sémantique : les deux procédures parlent du même sujet. Le problème est que la recherche a traité la similarité comme seul critère de pertinence.
Étape 3 — Les métadonnées et le cycle documentaire étaient-ils corrects ?
Marie ouvre la fiche de la version 3.8.
version : 3.8
remplacée par : 4.1
statut dans le référentiel documentaire : archivé
statut dans l'index vectoriel : absent
La cause devient plus précise : l’information « archivé » n’a pas été conservée lors de l’indexation.
Le moteur de recherche ne pouvait donc pas appliquer le filtre :
status = ACTIVEIl faut encore comprendre pourquoi :
- le connecteur ne lisait pas ce champ ;
- le schéma de métadonnées ne le prévoyait pas ;
- la version 3.8 n’a pas été supprimée de l’index ;
- la synchronisation a échoué ;
- le statut a été modifié après l’indexation sans déclencher de mise à jour.
Le diagnostic se déplace encore : ce n’est plus seulement un problème de retrieval. C’est un problème de synchronisation entre le cycle documentaire et l’index de recherche.
Étape 4 — Le prompt devait-il permettre une abstention ?
Même avec un bon retrieval, des sources contradictoires peuvent apparaître.
Un prompt fragile pourrait dire :
Réponds à la question de l'utilisateur à partir des sources.Un prompt plus robuste pourrait ajouter :
Utilise uniquement les documents actifs.
Si plusieurs sources applicables se contredisent,
ne choisis pas silencieusement.
Explique la contradiction et demande une vérification.
Le prompt n’est pas la correction principale de notre incident : il ne peut pas restaurer une métadonnée absente. Mais il peut réduire l’impact lorsqu’une contradiction reste visible dans le contexte.
Cette distinction est importante :
contrôle principal
→ filtrer les documents archivés avant le LLM

contrôle de défense supplémentaire
→ demander au LLM de signaler les contradictions
Étape 5 — Un tool ou une donnée opérationnelle a-t-il contribué à l’erreur ?
Dans ce scénario précis, aucun tool n’a été utilisé. Cette absence doit être visible dans la trace.
Dans un autre cas, la même phrase pourrait provenir d’un service métier :
get_trip_regularization_policy
→ { "delayHours": 24 }
Il faudrait alors vérifier :
- le bon tool a-t-il été choisi ?
- les bons arguments ont-ils été envoyés ?
- le pays et le type d’abonnement étaient-ils corrects ?
- le service a-t-il retourné une valeur ancienne ?
- le résultat a-t-il été correctement interprété ?
- un timeout a-t-il conduit à réutiliser une valeur en cache ?
Un tool peut réussir techniquement et rester faux du point de vue métier.
HTTP 200
≠
résultat métier correct
Étape 6 — Le workflow ou l’agent a-t-il pris un mauvais chemin ?
Un agent peut atteindre son objectif final tout en suivant un déroulement inacceptable.
Exemple :
objectif atteint
→ réponse envoyée à Marie

mais
→ document archivé consulté
→ source active ignorée
→ aucune contradiction signalée
→ validation humaine contournée
Évaluer un agent revient donc à poser trois questions au lieu d’une, dans cet ordre.
A-t-il atteint son objectif ? C’est la question habituelle, et la seule que mesure un test classique. Elle porte sur l’état final réellement obtenu — pas sur ce que l’agent en a dit.
Par où est-il passé ? Les étapes suivies, les tools appelés, les données consultées, les boucles et les retries. Un chemin plus long qu’attendu signale rarement un hasard.
Que s’est-il autorisé en route ? Les tentatives d’actions interdites, les escalades, la condition d’arrêt effectivement déclenchée. Une tentative refusée n’est pas un non-événement : c’est le signe que l’agent a envisagé quelque chose que la politique lui interdisait.
Le succès de la tâche ne suffit pas. Le chemin doit lui aussi être acceptable.
Étape 7 — L’artefact final est-il utilisable ?
Une réponse textuelle peut alimenter un e-mail, un PDF, une image ou une fiche client.
Si Bikaroo génère un document indiquant le mauvais délai, il faut évaluer à la fois :
contenu
→ règle correcte et sources valides

artefact
→ fichier lisible, versionné et correctement diffusé
Pour un document, on vérifiera notamment :
- le contenu ;
- les citations ;
- le statut du document ;
- les liens ;
- les données personnelles ;
- la version du modèle spécialisé ou du générateur ;
- l’assetId ;
- le statut de validation.
Une bonne réponse dans la trace ne garantit pas que le fichier final envoyé à l’utilisateur soit correct.
Observer l’exécution pour vérifier les hypothèses
Sans trace, l’équipe ne peut qu’essayer de reproduire la réponse et deviner ce qui s’est passé. Or une solution probabiliste peut produire une réponse différente à la tentative suivante.
L’observabilité doit conserver assez d’éléments pour reconstruire l’exécution, sans transformer les logs en nouvelle fuite de données.
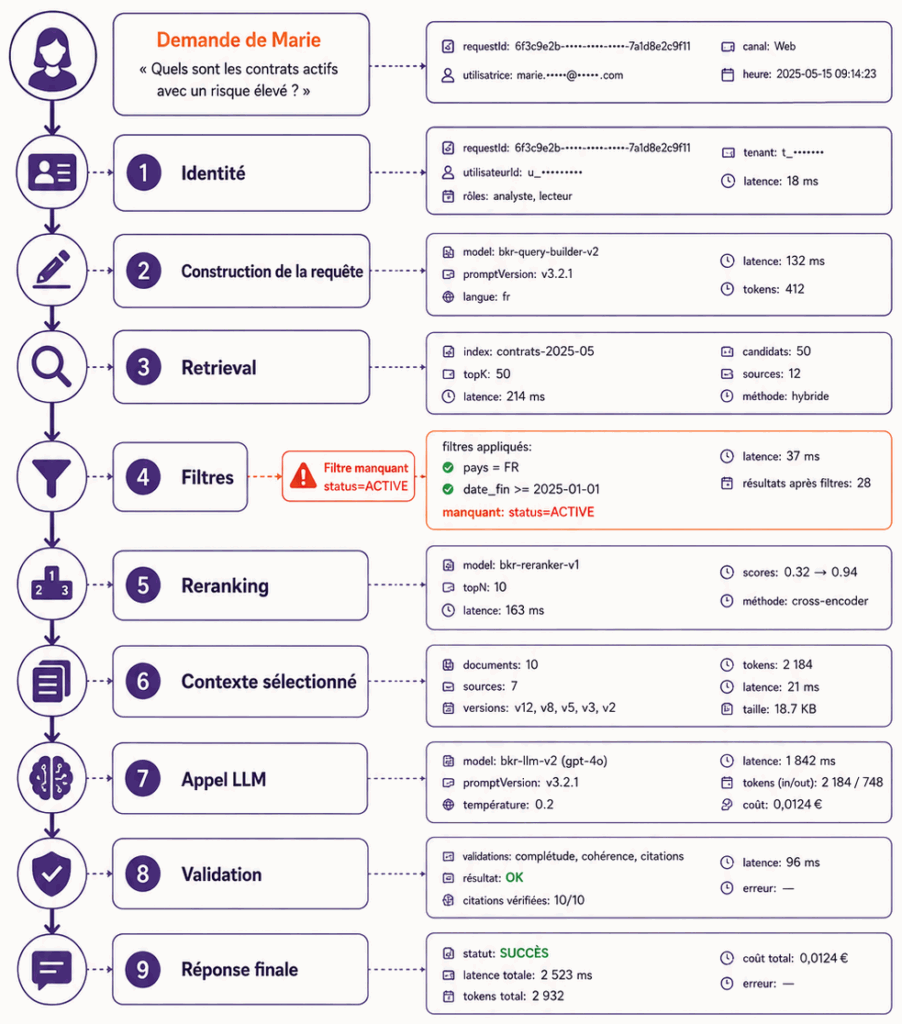
Reconstituer la requête de Marie
Une trace exploitable pourrait ressembler à ceci :
requestId        = REQ-78421
user             = Marie / Customer Care
question         = « Quel délai s'applique à ce trajet ouvert ? »
model            = BIK-LLM-02
promptVersion    = SUPPORT-RAG-v7
retrievalQuery   = « délai régularisation trajet ouvert »
filters          = language=fr, country=BE
missingFilter    = status=ACTIVE
retrievedChunks  = PROC-3.8#12, PROC-4.1#09
selectedContext  = PROC-3.8#12
response         = « dans les vingt-quatre heures »
latency          = 2,8 s
cost             = ...
Cette trace permet déjà d’écarter certaines hypothèses :
- le modèle et le prompt sont identifiés ;
- aucun tool n’a été appelé ;
- l’ancienne version a bien été retrouvée ;
- le filtre de statut est absent ;
- la réponse est cohérente avec le passage sélectionné.
Le diagnostic ne repose plus sur une impression.
Découper la trace en étapes
Une requête peut être représentée par des étapes, parfois appelées spans :
span 1 — réception et identité
span 2 — construction de la requête de recherche
span 3 — retrieval
span 4 — reranking et sélection du contexte
span 5 — appel LLM
span 6 — validation de la réponse
span 7 — présentation à Marie
Pour chaque étape, on peut conserver :
- l’entrée ;
- la sortie ;
- la version du composant ;
- la durée ;
- les erreurs ;
- les décisions de filtrage ;
- les identifiants nécessaires à la corrélation.
Cette granularité permet d’identifier l’étape lente, coûteuse ou fautive.
Tracer sans exposer les données
Une trace utile peut contenir :
identifiants de corrélation
versions du modèle et du prompt
identifiants et versions des sources
scores de retrieval
filtres appliqués
appel et résultat des tools
résultat des validations
latence, tokens et coût
erreurs et retries
Elle ne doit pas nécessairement contenir :
prompt complet non masqué
document confidentiel complet
clé API ou token d'accès
données personnelles non nécessaires
fichier binaire intégral
EN PRATIQUE
Dans notre scénario, le diagnostic exige l’identifiant et la version de la procédure. Il n’exige pas de recopier dans les logs l’intégralité du dossier de Stéphane.
Choisir des métriques qui déclenchent une décision
Une métrique n’est utile que si l’équipe sait quoi faire lorsqu’elle évolue.
Exemples :
| Signal | Interprétation possible | Action |
|---|---|---|
| hausse des réponses sans source | problème de prompt ou de retrieval | bloquer le déploiement et analyser les traces |
| documents archivés retrouvés | filtre ou synchronisation défaillante | réindexer et corriger le pipeline |
| latence du retrieval en hausse | index ou filtres dégradés | analyser le span de recherche |
| taux d’abstention en baisse | modèle plus affirmatif ou prompt modifié | réexécuter les tests sensibles |
| coût par dossier en hausse | contexte ou boucles plus longs | comparer les versions et les parcours |
| hausse des corrections humaines | qualité métier en baisse | échantillonner et classifier les erreurs |
Transformer l’incident en amélioration durable
Le diagnostic de Bikaroo est maintenant établi :
symptôme
→ réponse incorrecte sur le délai

cause immédiate
→ ancienne procédure sélectionnée

cause technique
→ statut archivé absent des métadonnées de l'index

cause de processus
→ mise à jour documentaire non synchronisée avec le pipeline RAG
La correction doit traiter plusieurs niveaux.
Corriger la bonne couche
Actions immédiates :
- retirer ou désactiver la version 3.8 dans l’index ;
- réindexer la version 4.1 avec ses métadonnées ;
- appliquer le filtre
status=ACTIVE; - vérifier que les droits et dates d’effet sont conservés ;
- réexécuter la question de Marie.
Actions préventives :
- ajouter le statut au schéma obligatoire de métadonnées ;
- déclencher une réindexation lors d’un changement de statut ;
- alerter lorsque plusieurs versions actives se contredisent ;
- ajouter une règle d’abstention en cas de contradiction ;
- attribuer un propriétaire au pipeline documentaire.
ERREUR
Modifier uniquement le prompt aurait pu réduire certains symptômes, mais n’aurait pas réparé le cycle documentaire.
Créer le test de non-régression
Le cas devient un test permanent :
Question :
« Dans quel délai peut-on régulariser un trajet resté ouvert ? »

Corpus :
PROC-3.8 archivée
PROC-4.1 active

Attendu :
PROC-4.1 retrouvée et citée
PROC-3.8 exclue
aucune affirmation « vingt-quatre heures »
Ce test doit être réexécuté lorsqu’un composant change :
- modèle ;
- prompt ;
- embeddings ;
- chunking ;
- filtres ;
- reranking ;
- connecteur documentaire ;
- schéma de métadonnées ;
- workflow.
Comparer une version A et une version B ne signifie pas seulement demander laquelle répond le mieux en moyenne. Il faut vérifier qu’aucune amélioration globale ne réintroduit une erreur grave déjà corrigée.
Détecter les dérives
Une solution peut se dégrader sans modification visible du code applicatif.
modèle mis à jour
corpus modifié
vocabulaire utilisateur évolué
tool changé
nouvelle attaque
nouvelle politique métier
Dans Bikaroo, les indicateurs pourraient inclure :
- proportion de réponses utilisant la dernière version applicable ;
- taux de retrieval de documents archivés ;
- taux de contradictions documentaires ;
- taux d’abstention ;
- corrections effectuées par Marie ;
- erreurs de permissions ;
- coûts et latences par type de demande.
Le suivi doit comparer des périodes et des versions. Une valeur isolée indique rarement la cause.
Construire un tableau de bord actionnable
Un tableau de bord ne doit pas accumuler des chiffres sans propriétaire ni seuil.
Pour chaque métrique, préciser :
ce qu'elle mesure
pourquoi elle compte
qui la surveille
quel seuil déclenche une analyse
quelle action est possible
Exemple :
| Métrique | Seuil | Responsable | Décision |
|---|---|---|---|
| documents archivés dans le top 5 | > 0 | équipe Knowledge | bloquer la publication de l’index |
| réponses sans citation | > 2 % | Product Owner | analyser prompt et retrieval |
| corrections métier confirmées | > 5 par semaine | Customer Care | enrichir les tests et classifier les causes |
| accès refusés anormaux | hausse soudaine | Security | analyser permissions et tentatives d’abus |
| coût moyen par dossier | +20 % | plateforme IA | comparer contexte, modèle et boucles |
ERREUR
Une métrique sans décision associée devient du bruit opérationnel.
Utiliser le feedback sans le confondre avec la vérité
Marie peut signaler :
réponse incorrecte
source obsolète
information manquante
action inappropriée
Ce retour est précieux, mais un clic « inutile » ne prouve pas automatiquement que la réponse est fausse. L’utilisateur peut avoir mal compris, chercher une autre formulation ou ignorer une règle récente.
Le feedback doit donc être :
- associé à la requête et aux sources ;
- regroupé par type d’erreur ;
- revu sur un échantillon ;
- transformé, lorsqu’il est confirmé, en cas de test.
Valider les évaluateurs automatiques
Une partie de l’évaluation peut être automatisée : règles, comparaison structurée, vérification de schéma, métriques de retrieval, classificateurs ou LLM-as-a-judge.
Mais l’évaluateur automatique doit lui-même être testé.
Un LLM juge peut préférer :
- une réponse plus longue ;
- une formulation plus assurée ;
- un style proche du sien ;
- la première réponse présentée ;
- une réponse bien écrite mais fondée sur une source obsolète.
Exemple :
Réponse A
→ courte, prudente, cite la procédure active

Réponse B
→ détaillée, fluide, cite une ancienne procédure
ERREUR
Un juge sensible au style peut préférer B. L’évaluation métier doit pourtant choisir A.
Les évaluations automatiques doivent être comparées périodiquement à des jugements humains qualifiés.
Auditer une décision sans figer le système
L’audit ne sert pas seulement à produire un rapport après incident. Il permet de répondre à des questions précises :
Quelle question a été posée ?
Quelle identité et quels droits étaient actifs ?
Quel modèle et quel prompt ont été utilisés ?
Quelles sources ont été consultées ?
Quelles versions étaient applicables ?
Quels tools et règles ont contribué ?
Quelle validation a été effectuée ?
Quel résultat a été présenté ou exécuté ?
Il doit aussi distinguer la nature de chaque information :
fait documentaire
donnée opérationnelle
inférence du modèle
recommandation
action réellement exécutée
Dans notre enquête :
fait documentaire fourni au modèle
→ ancienne procédure : vingt-quatre heures

inférence du modèle
→ cette règle répond à la question de Marie

réponse affichée
→ régularisation possible sous vingt-quatre heures

cause de l'incident
→ mauvaise version considérée comme applicable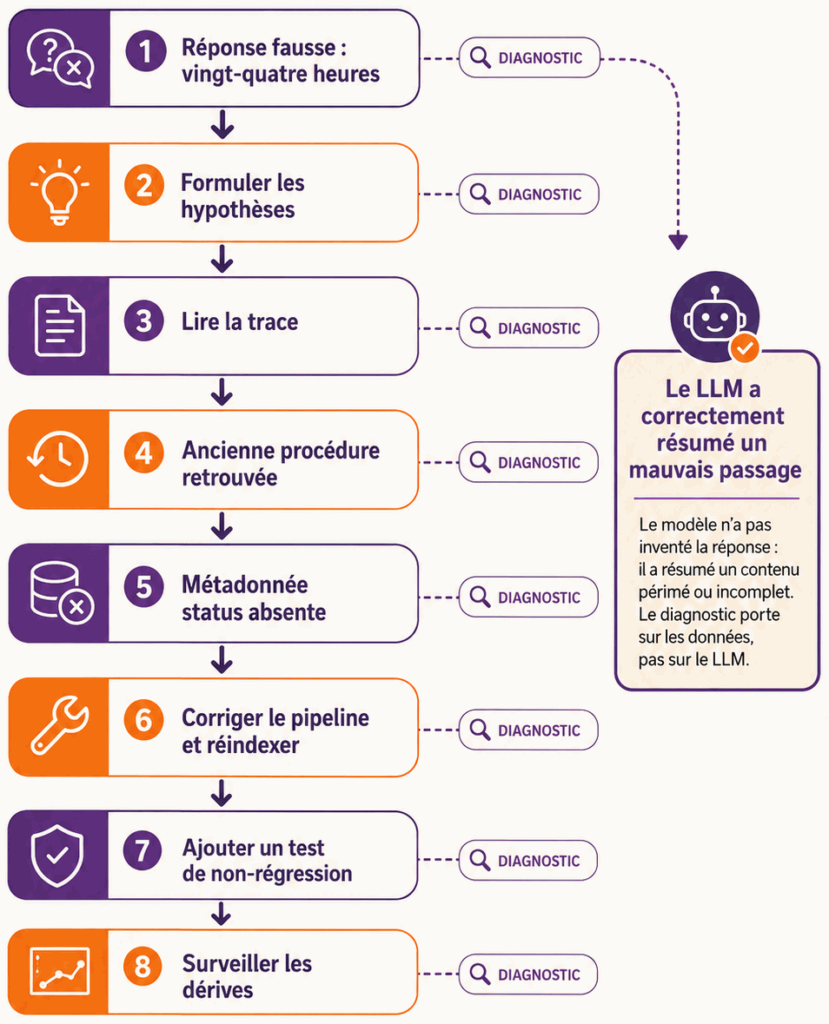
En résumé
L’enquête Bikaroo peut être résumée ainsi :
- Symptôme — une réponse incorrecte sur le délai de régularisation, signalée par Marie et non par une métrique.
- Évaluer — la réponse ne respecte pas la procédure active, alors qu’elle est fidèle au passage reçu.
- Observer — la trace montre que l’ancienne version a été retrouvée puis sélectionnée, sans qu’aucun filtre de statut ne s’applique.
- Auditer — le statut « archivé » existait dans le référentiel documentaire, mais n’avait jamais été propagé dans l’index.
- Corriger — les métadonnées, le filtre, la réindexation et une règle d’abstention en cas de contradiction.
- Prévenir — l’incident devient un test de non-régression, et les dérives sont suivies dans le temps.
Le message essentiel est :
Une mauvaise réponse n’indique pas automatiquement un mauvais modèle. Elle indique qu’une chaîne doit être diagnostiquée.
Une équipe mature ne modifie pas le système au hasard. Elle formule des hypothèses, consulte les traces, identifie la couche fautive, corrige au bon endroit et transforme chaque incident confirmé en test permanent.
Vérifiez votre compréhension
Question 1 — Pourquoi une réponse fidèle à sa source peut-elle rester fausse ?
Réponse : Parce que la fidélité — la groundedness — mesure l’accord entre la réponse et le passage fourni, pas entre la réponse et la réalité. Un modèle peut résumer parfaitement un document périmé. L’erreur est alors en amont du modèle, dans le choix de la source.
Question 2 — Quelle différence existe entre évaluation, observabilité et audit ?
Réponse : L’évaluation demande si le résultat est acceptable, l’observabilité ce qui s’est passé pendant l’exécution, l’audit si la décision peut être reconstruite et justifiée. Une évaluation sans observabilité détecte l’erreur sans l’expliquer ; une observabilité sans critères produit des traces sans verdict.
Question 3 — Pourquoi faut-il séparer retrieval et génération ?
Réponse : Parce que ce sont deux défaillances distinctes, qui appellent deux corrections différentes. Si le mauvais passage a été retrouvé, changer le prompt ne servira à rien ; si le bon passage a été mal exploité, réindexer ne servira à rien non plus. Les confondre conduit à corriger la couche visible plutôt que la couche fautive.
Question 4 — Que montre l’absence de filtre status=ACTIVE dans l’enquête Bikaroo ?
Réponse : Que le statut « archivé » existait dans le référentiel documentaire mais n’avait pas été propagé dans l’index. Le moteur ne pouvait donc pas écarter la version 3.8 : il ne savait pas qu’elle était périmée. Le défaut n’est ni dans le modèle ni dans la recherche, mais dans la synchronisation entre le cycle documentaire et le pipeline d’indexation.
Question 5 — Pourquoi un code HTTP 200 ne garantit-il pas un résultat métier correct ?
Réponse : Parce qu’il atteste que l’appel a abouti, pas que la réponse est la bonne. Un service peut retourner une valeur périmée, une valeur mise en cache après un timeout, ou une règle qui ne s’applique pas au pays ni au type d’abonnement concerné — le tout avec un statut technique irréprochable.
Question 6 — Pourquoi faut-il évaluer le chemin suivi par un agent ?
Réponse : Parce qu’un agent peut atteindre son objectif par un déroulement inacceptable : consulter un document archivé, ignorer la source active, contourner une validation. Le résultat seul ne révèle rien de tout cela, et une réussite obtenue ainsi se reproduira sans qu’on l’ait vue venir.
Question 7 — Comment transformer un incident en test de non-régression ?
Réponse : En figeant les trois éléments qui ont produit l’erreur : la question posée, l’état du corpus, et le comportement attendu — quelle source doit être retrouvée, laquelle doit être exclue, quelle affirmation ne doit plus apparaître. Le test est ensuite rejoué à chaque changement de modèle, de prompt, d’embeddings, de chunking, de filtres ou de connecteur.
Question 8 — Quelles informations faut-il conserver dans une trace sans créer une fuite ?
Réponse : Ce qui permet de vérifier une hypothèse : identifiants de corrélation, versions du modèle et du prompt, identifiants et versions des sources, scores de retrieval, filtres appliqués, appels de tools, résultats des validations, latence et coût. Pas le prompt complet non masqué, ni les documents entiers, ni les données personnelles inutiles au diagnostic.
Question 9 — Pourquoi le feedback utilisateur ne constitue-t-il pas toujours une vérité ?
Réponse : Parce qu’un signalement exprime une insatisfaction, pas un diagnostic. L’utilisateur peut avoir mal compris la réponse, chercher une autre formulation, ou ignorer une règle récente. Le feedback devient exploitable lorsqu’il est rattaché à la requête et aux sources, regroupé par type d’erreur, puis confirmé sur un échantillon.
Question 10 — À quelle condition une métrique devient-elle réellement utile ?
Réponse : Lorsqu’elle est associée à un seuil, à un responsable et à une action connue d’avance. Une métrique dont personne ne sait quoi faire quand elle bouge n’informe pas : elle occupe un tableau de bord.
Transition vers le chapitre suivant
L’enquête permet maintenant d’identifier la couche fautive, de corriger le bon composant et de vérifier que l’erreur ne réapparaît pas. Il reste à replacer toutes ces briques dans une architecture où leurs responsabilités et leurs frontières restent lisibles.
Le chapitre suivant sera :
Chapitre 14 — Architecture de référence d’une IA d’entreprise
Nous assemblerons le LLM, le RAG, les tools, MCP, l’orchestration, la mémoire, la sécurité et l’observabilité dans une carte cohérente, avant le passage aux ateliers.