Ouvrir le capot de l’IA
Quelle est la capitale de la Belgique ?
Du prompt à la réponse : que se passe-t-il dans un LLM ?
Introduction — Ouvrir le capot
Stéphane : Bonjour ! Quelle est la différence entre Amateur League, Semi-Pro League et Pro League ?
Assistant Bikaroo : Bikaroo propose trois formules de souscription. Amateur League vise les usages occasionnels, Semi-Pro League les usages réguliers et Pro League les usages intensifs.
Cette première interaction situe l’univers Bikaroo et rappelle surtout ce que nous percevons lorsque nous utilisons un assistant : nous écrivons une question et, quelques instants plus tard, une réponse apparaît. Entre les deux, l’interface ne nous montre presque rien. Elle donne facilement l’impression qu’une mystérieuse « IA » reçoit la question, la comprend, trouve la réponse et nous la restitue.
Dans l’introduction, nous avons déjà distingué le LLM, l’application, l’assistant et l’agent. Ici, nous allons volontairement repartir de cette vision beaucoup plus simple, celle que l’expérience utilisateur suggère avant d’avoir ouvert le capot. Ce premier chapitre va progressivement remplacer cette boîte noire par un modèle mental fonctionnel suffisamment précis pour comprendre les chapitres suivants, sans entrer dans toute la mécanique mathématique d’un réseau neuronal.
Pour isoler le mécanisme sans le mélanger à la connaissance des offres Bikaroo, nous allons momentanément utiliser une question factuelle volontairement simple, qui donne son titre au chapitre :
Quelle est la capitale de la Belgique ?Nous reviendrons ensuite au scénario Bikaroo. Pour l’instant, concentrons-nous sur ce qui se cache entre cette question et la réponse qui apparaît à l’écran.
Ce que vous allez apprendre
À la fin de ce chapitre, vous pourrez :
- expliquer comment une application construit le contexte transmis à un LLM ;
- distinguer l’entraînement du modèle de son utilisation en inférence ;
- décrire le rôle des tokens, des vecteurs et du Transformer ;
- expliquer pourquoi une réponse est générée progressivement, token après token ;
- distinguer ce qui appartient au modèle de ce qui appartient à l’application qui l’entoure.
Notre modèle mental de départ
Avant d’ouvrir le capot, notre modèle mental tient souvent en trois éléments : une question, une boîte noire que nous appelons « IA », puis une réponse.
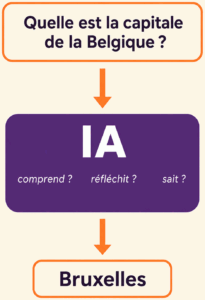
Ce modèle mental n’est pas absurde : il correspond assez bien à ce que l’expérience utilisateur donne à voir. Mais il ne dit rien de ce qui se passe réellement entre l’entrée et la sortie. La boîte pourrait « comprendre », chercher une réponse quelque part, raisonner comme nous, réciter une information apprise ou fonctionner d’une tout autre manière : à ce stade, nous n’en savons encore rien.
Notre objectif dans ce chapitre est précisément d’ouvrir cette boîte, pièce après pièce. À la fin du parcours, nous reviendrons au même trajet — de la question à la réponse — mais cette fois avec le capot ouvert.
Pour comprendre ce qui se passe dans cette boîte lorsqu’elle répond, il faut toutefois commencer un peu plus tôt : avant même que vous ne posiez votre question.
Avant votre question : le modèle a été entraîné
Avant que vous n’écriviez quoi que ce soit, le modèle a déjà subi une phase d’entraînement.
Durant cette phase, il a analysé de très grandes quantités de textes et appris à accomplir une tâche fondamentale :
prédire quel élément de texte devrait probablement venir ensuite.
Par exemple, durant son entraînement, il a pu rencontrer des phrases comme :
Bruxelles est la capitale de la Belgique.
La capitale belge est Bruxelles.
Belgique — Capitale : Bruxelles.
À force d’exemples, le modèle a progressivement appris des relations entre :
Belgique
capitale
Bruxelles
Ces relations ont été encodées dans les paramètres, ou poids, du réseau neuronal.
Ce que le modèle mémorise réellement
Il ne faut pas imaginer une base de données interne classique :
Pays       Capitale
Belgique   Bruxelles
France     Paris
Espagne    Madrid
Un LLM ne consulte pas nécessairement une table contenant la réponse.
La connaissance est distribuée dans un très grand nombre de paramètres numériques. Ces paramètres influencent les probabilités calculées pendant la génération.
On peut donc dire, de manière fonctionnelle :
Le modèle a appris qu’en présence des concepts « Belgique » et « capitale », la continuation « Bruxelles » est extrêmement plausible.
Entraînement et inférence
Il faut distinguer deux phases.
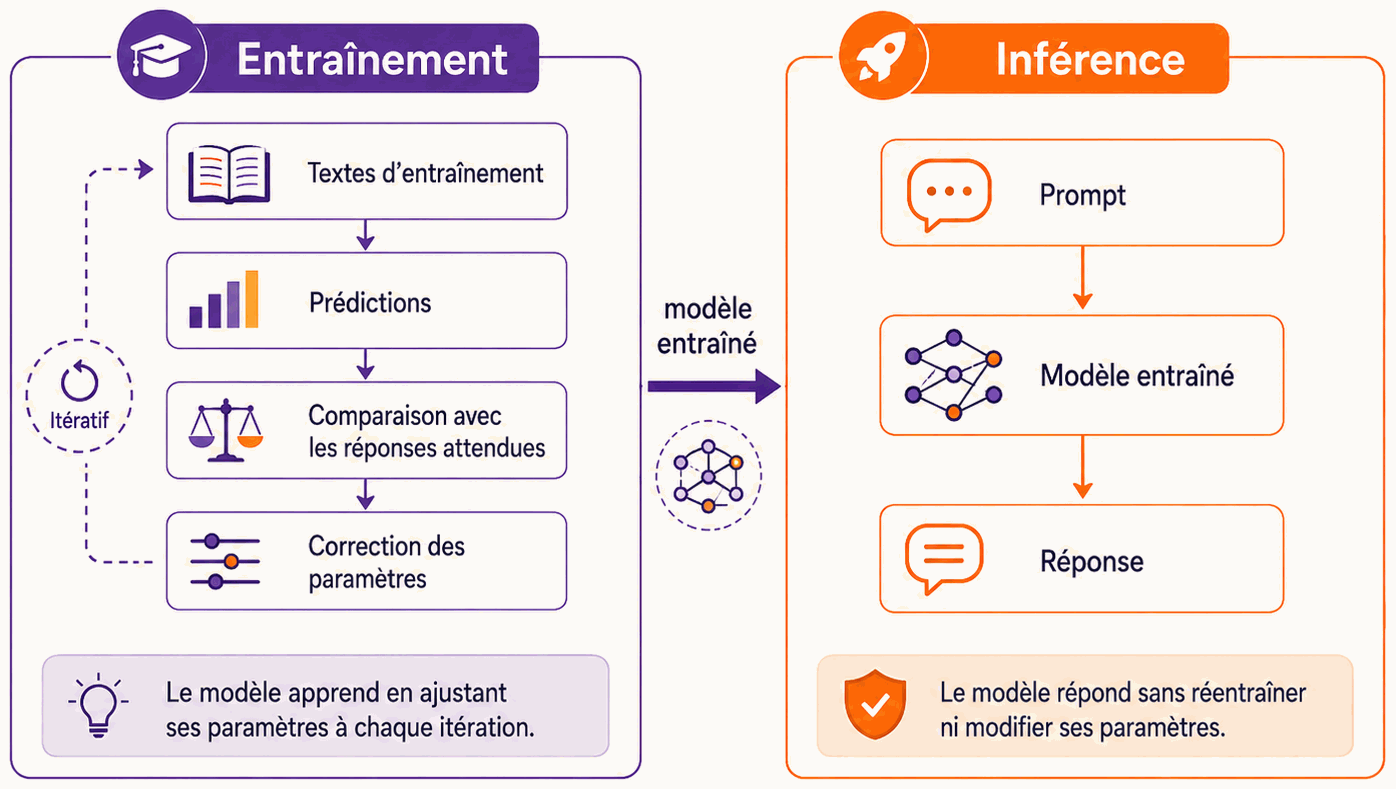
Entraînement
Durant cette phase, le modèle apprend en ajustant ses paramètres. Elle s’appuie sur un très grand volume de textes afin de faire évoluer les poids qui composent le réseau neuronal.
Inférence
Dès que son entraînement est terminé, le modèle est prêt à répondre aux demandes des utilisateurs.
Lorsque nous discutons avec un modèle dans une application de chat, nous sommes principalement dans la phase d’inférence.
Jusqu’ici, nous avons vu ce qui précède l’utilisation du modèle. Observons maintenant ce qui se passe lorsqu’une requête réelle arrive dans une application comme ChatGPT ou l’assistant Bikaroo.
Construction du contexte
Lorsque l’utilisateur écrit :
Quelle est la capitale de la Belgique ?le LLM ne reçoit pas nécessairement uniquement cette phrase.
L’application construit d’abord un contexte.
Ce contexte rassemble, en un seul bloc de texte, tout ce que le modèle voit au moment de répondre : les instructions — celles du système et celles de l’application ; la conversation — son historique et les réponses précédentes de l’assistant ; les apports de l’application — extraits de documents et résultats d’outils ou d’API ; et enfin le nouveau message de l’utilisateur.
Exemple de contexte simplifié
L’application pourrait construire quelque chose qui ressemble conceptuellement à ceci :
[SYSTÈME]
Tu es un assistant utile.
Réponds en français.
Sois précis et concis.

[UTILISATEUR]
Quelle est la capitale de la Belgique ?

[ASSISTANT]
Le marqueur [ASSISTANT] signifie que le modèle doit maintenant produire la suite correspondant à la réponse.
Le LLM ne voit jamais votre écran
Lorsque vous utilisez ChatGPT ou l’assistant Bikaroo, vous voyez une interface riche : fenêtres, boutons, menus, historique et éléments visuels.
Le modèle, lui, ne reçoit pas cette interface. Il reçoit essentiellement une séquence structurée de données qui sera ensuite transformée en tokens.
Cette distinction entre application et modèle est fondamentale pour comprendre le reste du livre.
L’historique fait partie du contexte
Imaginons la conversation suivante :
Utilisateur : Je vais te poser des questions sur la Belgique.
Assistant : D’accord.

Utilisateur : Quelle est sa capitale ?
Le mot « sa » ne suffit pas, pris isolément, à identifier le pays.
Mais si l’historique est ajouté au contexte, le modèle peut établir le lien avec la Belgique.
Le contexte envoyé pourrait être :
Utilisateur : Je vais te poser des questions sur la Belgique.
Assistant : D’accord.
Utilisateur : Quelle est sa capitale ?
Assistant :
L’historique n’est donc pas une mémoire magique située à l’intérieur du LLM. Il est généralement réinjecté dans le contexte par l’application.
Tokenisation
Le texte du contexte est ensuite découpé en unités appelées tokens.
Un token peut être :
- un mot entier ;
- une partie de mot ;
- un signe de ponctuation ;
- un nombre ;
- un symbole ;
- parfois un espace associé au mot suivant.
La phrase :
Quelle est la capitale de la Belgique ?pourrait être découpée conceptuellement comme ceci :
["Quelle", " est", " la", " capitale", " de", " la", " Belgique", " ?"]Le découpage réel dépend du tokenizer utilisé par le modèle.
Les tokens sont transformés en identifiants
Chaque token appartient au vocabulaire du modèle et possède un identifiant numérique unique.
Exemple fictif :
"Quelle"    → 18432
" est"      → 392
" la"       → 271
" capitale" → 8914
" de"       → 325
" Belgique" → 14587
" ?"        → 30
La séquence devient donc quelque chose comme :
[18432, 392, 271, 8914, 325, 271, 14587, 30]Ces nombres sont fictifs, mais le principe est correct.
Ce que la tokenisation ne fait pas
La tokenisation :
- ne comprend pas la question ;
- ne détecte pas encore formellement l’intention ;
- ne cherche pas la réponse ;
- ne sait pas que Bruxelles est la capitale de la Belgique.
Elle transforme simplement le texte en unités que le modèle peut traiter.
Une analogie possible est celle d’un texte découpé en pièces de puzzle. Le découpage prépare les pièces, mais ne reconstitue pas encore l’image.
Qu’est-ce qui est tokenisé à ce moment-là ?
Au début de la génération, tout ce qui existe déjà est tokenisé :
Instructions système
+ historique
+ ancienne réponse éventuelle
+ nouvelle question
La nouvelle réponse n’est pas encore tokenisée comme un bloc complet, puisqu’elle n’existe pas encore.
Elle sera produite progressivement sous forme de nouveaux tokens.
Conversion des tokens en vecteurs
Le réseau neuronal ne travaille pas directement avec des mots ni avec de simples identifiants.
Chaque identifiant de token est converti en une représentation numérique appelée embedding.
Un embedding est un vecteur, c’est-à-dire une liste de nombres :
Token "Belgique"
        ↓
[0,17 ; -0,42 ; 0,08 ; 0,91 ; ...]
Dans un modèle réel, le vecteur peut contenir des milliers de dimensions. Chaque dimension participe à la représentation du token, mais n’a généralement pas de signification explicite pour un humain. On peut néanmoins imaginer, à titre pédagogique, qu’un token comme vélo active davantage certaines caractéristiques liées à des notions comme véhicule, deux-roues, guidon ou mobilité urbaine. En pratique, ces informations sont réparties de manière distribuée sur de nombreuses dimensions plutôt que stockées dans des champs clairement identifiables.
Pourquoi utiliser des vecteurs ?
Les vecteurs permettent au réseau neuronal de manipuler mathématiquement les tokens.
Ils offrent une représentation beaucoup plus riche qu’un simple identifiant.
L’identifiant :
14587signifie seulement :
voici le token numéro 14587 dans le vocabulaire.
Le vecteur, lui, permet au modèle de travailler avec des relations apprises entre les tokens et les concepts.
La position des tokens compte également
Le modèle doit distinguer :
La Belgique a pour capitale Bruxelles.de :
Bruxelles a pour capitale la Belgique.Les mots sont proches, mais leur ordre modifie complètement le sens.
Le système ajoute donc également des informations de position aux représentations des tokens.
Le modèle ne traite pas seulement :
Belgique
capitale
Bruxelles
mais aussi leur place et leurs relations dans la séquence.
Traitement par le Transformer
Les vecteurs traversent ensuite les nombreuses couches du Transformer.
Le Transformer constitue le cœur du LLM.
C’est principalement à cet endroit que le modèle :
- met les tokens en relation ;
- tient compte de leur position ;
- analyse le contexte ;
- identifie les éléments pertinents ;
- mobilise les relations apprises durant l’entraînement ;
- construit une représentation contextualisée de la demande.
Le mécanisme d’attention
Le Transformer utilise notamment un mécanisme appelé attention.
L’attention permet à chaque position de la séquence de tenir compte des autres positions pertinentes.
Dans :
Quelle est la capitale de la Belgique ?le modèle peut établir une forte relation entre :
capitale
Belgique
Il peut également tenir compte du fait que :
- la phrase est une question ;
- « quelle » demande une information ;
- la réponse doit probablement être un nom de ville ;
- la Belgique est l’entité concernée ;
- le contexte attend maintenant une réponse de l’assistant.
La compréhension n’est pas une étape séparée
Il serait tentant d’imaginer le processus suivant :
1. Le modèle lit la question.
2. Il la comprend.
3. Il trouve mentalement la réponse : Bruxelles.
4. Il traduit cette réponse en texte.
Ce modèle mental est trop proche du fonctionnement humain.
Le LLM effectue plutôt un calcul continu :
Tokens
   ↓
Transformations successives
   ↓
Représentation contextuelle
   ↓
Probabilités du prochain token
La « compréhension » correspond fonctionnellement à la construction d’une représentation interne suffisamment riche pour prédire une continuation pertinente.
Une représentation distribuée
À la sortie des couches du Transformer, il n’existe pas nécessairement une variable lisible comme :
INTENTION = demander une capitale
PAYS = Belgique
RÉPONSE = Bruxelles
Le résultat est une représentation mathématique distribuée.
De manière pédagogique, on peut néanmoins l’interpréter ainsi :
Il s’agit d’une question factuelle.
L’entité concernée est la Belgique.
La propriété demandée est sa capitale.
Une réponse de type ville est attendue.
Bruxelles est fortement associée à cette relation.
Cette interprétation est utile pour comprendre le fonctionnement, mais elle ne correspond pas nécessairement à des champs explicites présents dans le modèle.
Calcul du prochain token
À partir de la représentation finale produite par le Transformer, une couche de sortie calcule un score pour chaque token du vocabulaire.
Ces scores sont souvent appelés logits.
Le modèle peut posséder un vocabulaire de dizaines ou de centaines de milliers de tokens. Il attribue donc un score à chacun d’eux.
Exemple pédagogique :
Token candidat    Score relatif
--------------------------------
"La"              très élevé
"Bruxelles"       élevé
"Paris"           très faible
"Belgique"        faible
"Je"              moyen
Ces scores sont ensuite transformés en probabilités.
Exemple fictif :
"La"          54 %
"Bruxelles"   38 %
"Il"           2 %
"Paris"        0,1 %
...
Le modèle ne produit pas encore forcément toute la réponse « La capitale de la Belgique est Bruxelles ».
Il choisit d’abord uniquement le prochain token.
Pourquoi « La » pourrait être plus probable que « Bruxelles » ?
Plusieurs réponses sont linguistiquement correctes :
Bruxelles.ou :
La capitale de la Belgique est Bruxelles.Le modèle tient compte :
- du style demandé ;
- des instructions système ;
- des exemples appris ;
- de la formulation de la question ;
- des paramètres de génération.
Dans un contexte conversationnel, une phrase complète peut être jugée plus naturelle qu’une réponse composée d’un seul mot.
La réponse complète n’est pas nécessairement planifiée à l’avance
Le modèle ne doit pas obligatoirement construire d’abord cette chaîne complète :
La capitale de la Belgique est Bruxelles.puis la restituer.
Il génère le plus souvent la réponse de manière autorégressive, c’est-à-dire token après token.
Sélection du prochain token
Une fois les probabilités calculées, un mécanisme de décodage sélectionne le prochain token.
Le système pourrait toujours choisir le token ayant la probabilité la plus élevée :
"La" → 54 %Cette approche est relativement déterministe. Pour produire des formulations plus variées, le système peut également échantillonner parmi plusieurs tokens plausibles.
Plusieurs paramètres permettent de contrôler cette sélection :
- la température accentue ou atténue les écarts entre les probabilités : une valeur basse favorise les choix les plus prévisibles, tandis qu’une valeur plus élevée laisse davantage de place aux alternatives ;
top-klimite la sélection aux k tokens les plus probables ;top-pconserve le plus petit ensemble de tokens dont les probabilités cumulées atteignent un seuil donné ;- les pénalités de répétition réduisent la probabilité de réutiliser trop souvent les mêmes tokens ou formulations.
Pour une question factuelle, des réglages restrictifs favorisent généralement une réponse stable. Pour une tâche créative, une plus grande diversité peut être utile. Ces paramètres ne rendent pas le modèle plus intelligent : ils modifient seulement la manière dont le prochain token est choisi.
Le token généré rejoint le contexte
Supposons que le modèle sélectionne :
"La"Ce token est ajouté à la séquence.
Le contexte devient conceptuellement :
Utilisateur : Quelle est la capitale de la Belgique ?
Assistant : La
Le modèle recalcule alors les probabilités du token suivant.
Exemple fictif :
" capitale"   93 %
" Belgique"    1 %
" ville"       1 %
...
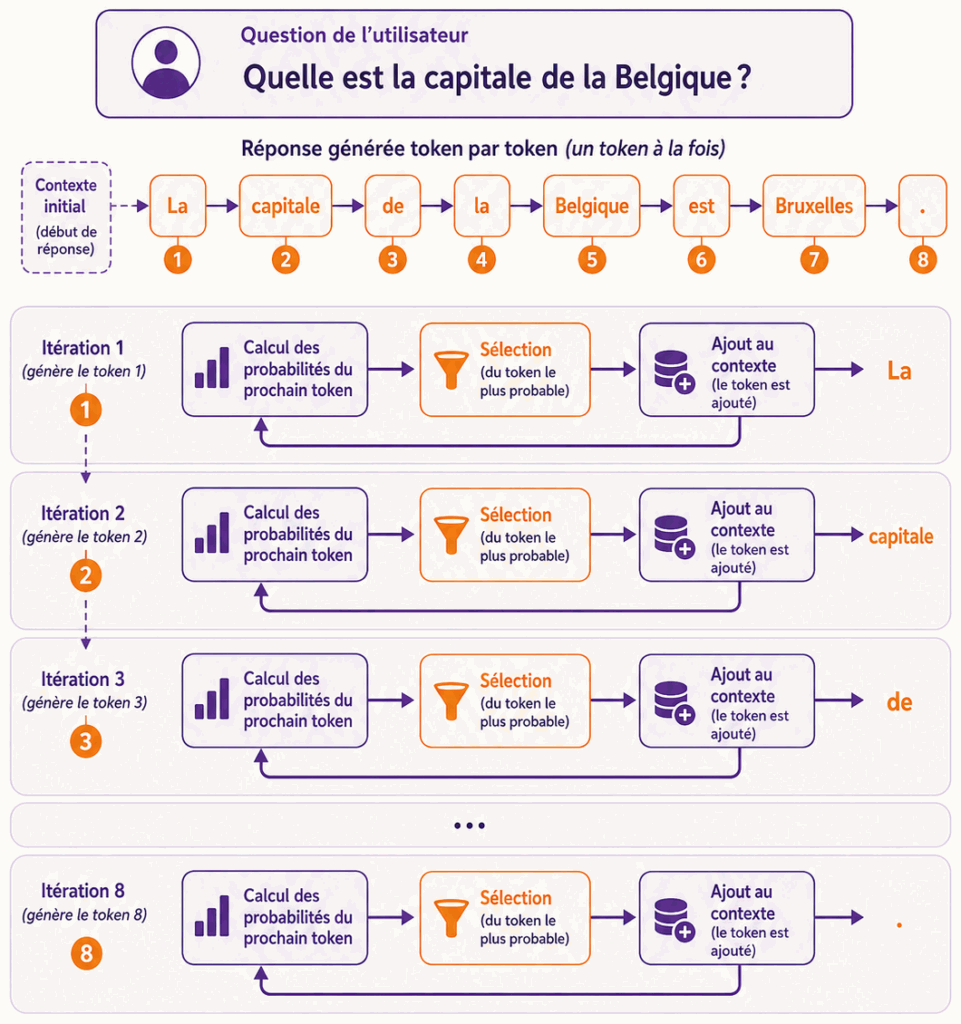
Il sélectionne " capitale", l’ajoute à son tour au contexte, puis recommence. Cette boucle de génération est dite autorégressive : chaque nouveau token est choisi en tenant compte du contexte initial et de tous les tokens déjà produits.
Dans notre exemple, la génération pourrait se dérouler ainsi :
| Itération | Token sélectionné | Réponse en cours |
|---|---|---|
| 1 | "La" | La |
| 2 | " capitale" | La capitale |
| 3 | " de" | La capitale de |
| 4 | " la" | La capitale de la |
| 5 | " Belgique" | La capitale de la Belgique |
| 6 | " est" | La capitale de la Belgique est |
| 7 | " Bruxelles" | La capitale de la Belgique est Bruxelles |
| 8 | "." | La capitale de la Belgique est Bruxelles. |
| 9 | <FIN> | génération terminée |
Le résultat affiché est :
La capitale de la Belgique est Bruxelles.
Pourquoi les tokens apparaissent-ils progressivement à l’écran ?
L’application peut afficher les tokens dès qu’ils sont générés.
Ce mécanisme est appelé streaming.
Le modèle ou le serveur envoie progressivement :
La
La capitale
La capitale de
La capitale de la Belgique
La capitale de la Belgique est Bruxelles.
Le streaming donne à l’utilisateur une impression de réponse en temps réel.
Comment le modèle sait-il qu’il doit s’arrêter ?
Le modèle ne s’arrête pas parce qu’il ne trouve plus aucun token probable.
Il existe toujours des continuations possibles.
Après :
La capitale de la Belgique est Bruxelles.le modèle pourrait encore produire :
Bruxelles est également le siège de plusieurs institutions européennes.ou :
Elle se situe dans la Région de Bruxelles-Capitale.La génération s’arrête généralement pour l’une des raisons suivantes.
Token spécial de fin
Le modèle peut sélectionner un token spécial :
<FIN>ou :
<EOS>pour End Of Sequence.
Ce token signifie que la réponse peut se terminer.
Après une réponse courte et complète, sa probabilité devient généralement élevée.
Limite maximale de sortie
L’application peut imposer :
max_output_tokens = 500La génération s’arrête alors après 500 tokens, même si le modèle voulait continuer.
Dans ce cas, la réponse peut être coupée au milieu d’une phrase.
Séquence d’arrêt
L’application peut définir une chaîne particulière comme signal d’arrêt.
Exemple :
---FIN---Dès que cette séquence apparaît, la génération est interrompue.
Taille maximale de la fenêtre de contexte
Le modèle possède une taille maximale de contexte.
Cette fenêtre contient :
tokens d’entrée
+ tokens déjà générés
Lorsque cette fenêtre est saturée, la génération ne s’interrompt pas d’elle-même : c’est l’application qui intervient, en tronquant le contexte, en refusant la requête ou en renvoyant une erreur.
Interruption externe
La génération peut également être arrêtée par :
- l’utilisateur ;
- l’application ;
- une erreur ;
- un délai maximal ;
- un mécanisme de sécurité ;
- une rupture de connexion.
Détokenisation et affichage
Les tokens générés sont finalement reconvertis en texte lisible.
Par exemple :
["La", " capitale", " de", " la", " Belgique", " est", " Bruxelles", "."]devient :
La capitale de la Belgique est Bruxelles.Cette opération est appelée détokenisation.
L’application reçoit ensuite ce texte et l’affiche dans l’interface.
Le rôle des garde-fous
Une application de chat moderne ne se limite pas au LLM.
Des mécanismes de sécurité peuvent intervenir à plusieurs endroits :
Message utilisateur
        ↓
Contrôle éventuel de l’entrée
        ↓
Construction du contexte avec instructions de sécurité
        ↓
LLM entraîné à suivre certaines règles
        ↓
Contrôle éventuel de la sortie
        ↓
Affichage
Les garde-fous peuvent prendre plusieurs formes :
- règles apprises durant l’entraînement ;
- instructions système ;
- modèles de classification séparés ;
- filtres d’entrée ;
- filtres de sortie ;
- restrictions d’accès aux outils ;
- règles applicatives.
Il est donc préférable de parler de mécanismes de sécurité distribués plutôt que d’une unique « couche de censure ».
Ces mécanismes distribués deviendront plus importants lorsque nous aborderons les agents, les outils et l’accès à des systèmes externes.
Ce que fait le LLM… et ce qu’il ne fait pas
Du point de vue de l’utilisateur, le modèle semble remplir plusieurs fonctions :
- répondre à des questions ;
- traduire ;
- résumer ;
- classifier ;
- générer du code ;
- produire du JSON ;
- rédiger un texte ;
- extraire des informations.
Pourtant, le mécanisme fondamental reste largement le même :
calculer une distribution de probabilités sur le prochain token, puis répéter cette opération à mesure que la réponse se construit.
Exemple : question factuelle
Quelle est la capitale de la Belgique ?Continuation attendue :
La capitale de la Belgique est Bruxelles.Exemple : traduction
Traduis en anglais : « La Belgique est un pays européen. »Continuation attendue :
Belgium is a European country.Exemple : classification
Classe ce message en POSITIF ou NÉGATIF :
« Ce service est excellent. »
Continuation attendue :
POSITIFExemple : JSON
Retourne le pays et sa capitale en JSON.Continuation attendue :
{
  "pays": "Belgique",
  "capitale": "Bruxelles"
}
Dans tous ces cas, le modèle génère des tokens. La différence provient principalement du contexte et des instructions.
Ce que le LLM ne possède pas automatiquement
Dans sa version la plus simple, un LLM ne possède pas automatiquement :
- un accès à Internet ;
- une mémoire permanente ;
- une base de données vectorielle ;
- un moteur de recherche ;
- un accès à une base de données d’entreprise ;
- la capacité d’envoyer un e-mail ;
- la capacité d’exécuter un paiement ;
- la capacité de vérifier systématiquement ses propres affirmations ;
- une connaissance garantie de l’actualité.
Le LLM reçoit un contexte et génère une suite de tokens. Les autres capacités sont ajoutées autour de lui par l’application.
LLM et application de chat : ne pas les confondre
Il est essentiel de distinguer :
Le LLM
Le LLM :
- reçoit des tokens ;
- produit des probabilités ;
- génère des tokens ;
- utilise les relations apprises dans ses paramètres.
L’application
L’application fait tout le reste — c’est-à-dire presque tout. Elle présente — affiche l’interface, gère les utilisateurs. Elle prépare — conserve éventuellement l’historique, construit le contexte, applique ses règles. Elle appelle le LLM et affiche la réponse. Et elle peut étendre ses capacités : appeler des outils, ajouter un RAG, gérer une mémoire externe.
On peut résumer ainsi :
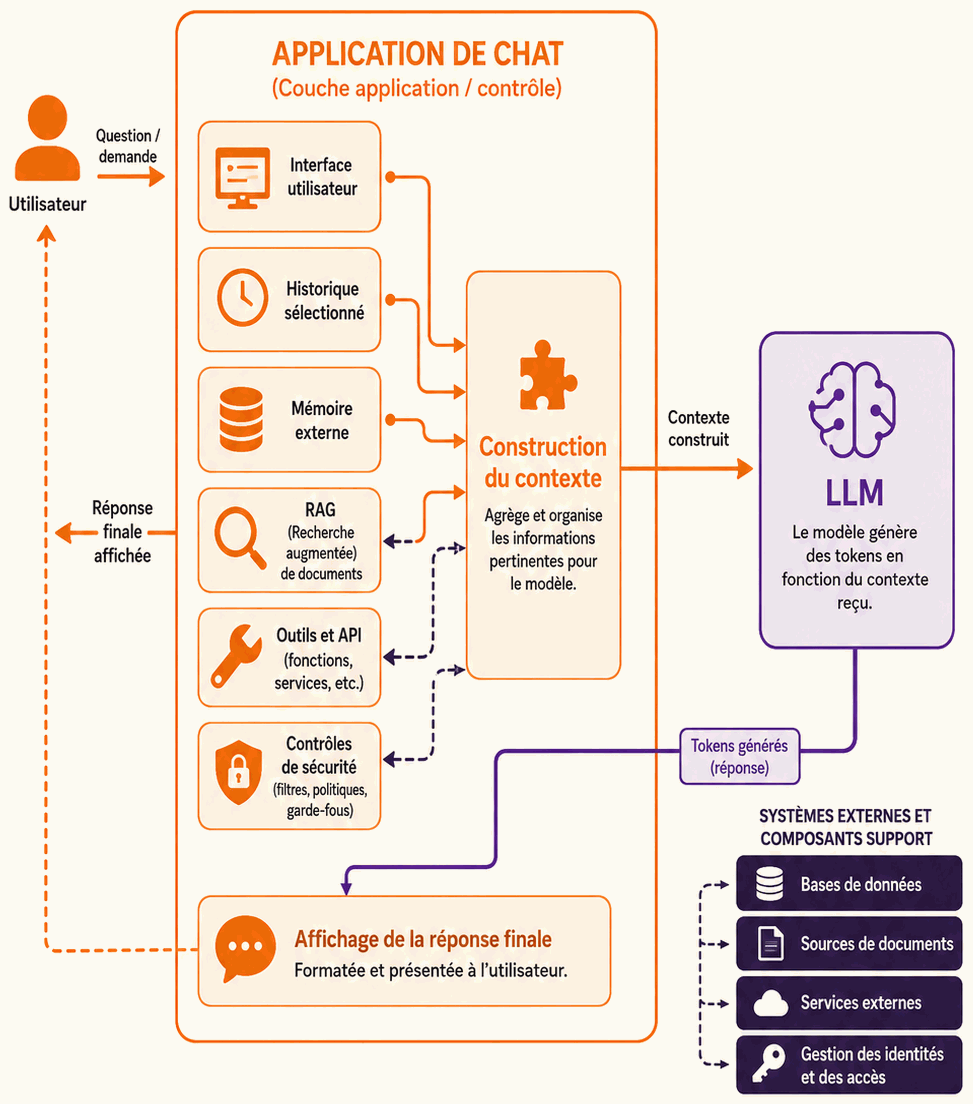
ChatGPT, par exemple, est une application complète qui utilise un ou plusieurs modèles et de nombreux composants autour d’eux.
Compréhension humaine et compréhension fonctionnelle
Le mot « comprendre » peut recouvrir deux réalités différentes.
Un humain possède une expérience du monde, relie les concepts à ses perceptions et peut avoir des intentions propres. Un LLM, lui, construit des représentations internes suffisamment riches pour distinguer des significations, relier des concepts, suivre des instructions et généraliser à de nouveaux exemples.
On peut donc parler de compréhension fonctionnelle, à condition de ne pas lui attribuer automatiquement une conscience ou une compréhension humaine.
Dans notre exemple, le modèle représente suffisamment bien la relation Belgique → capitale → Bruxelles pour produire une réponse correcte.
Pourquoi le modèle peut-il malgré tout se tromper ?
Le modèle calcule des continuations plausibles. Il ne consulte pas systématiquement une source vérifiée.
Il peut donc produire une réponse :
- linguistiquement fluide ;
- statistiquement plausible ;
- mais factuellement incorrecte.
C’est ce que l’on appelle souvent une hallucination.
Sur une question très connue comme la capitale de la Belgique, le risque est faible.
Sur une question obscure, récente ou ambiguë, le risque augmente.
Exemple :
Quelle est la capitale administrative d’une organisation récemment créée ?Si l’information n’est pas bien représentée dans les paramètres du modèle ou dans le contexte fourni, il peut inventer une réponse plausible.
C’est précisément pour réduire ce risque que l’on peut ajouter :
- une recherche Web ;
- un RAG ;
- une base de connaissances ;
- un appel API ;
- une validation externe.
Ces mécanismes seront étudiés dans les chapitres suivants.
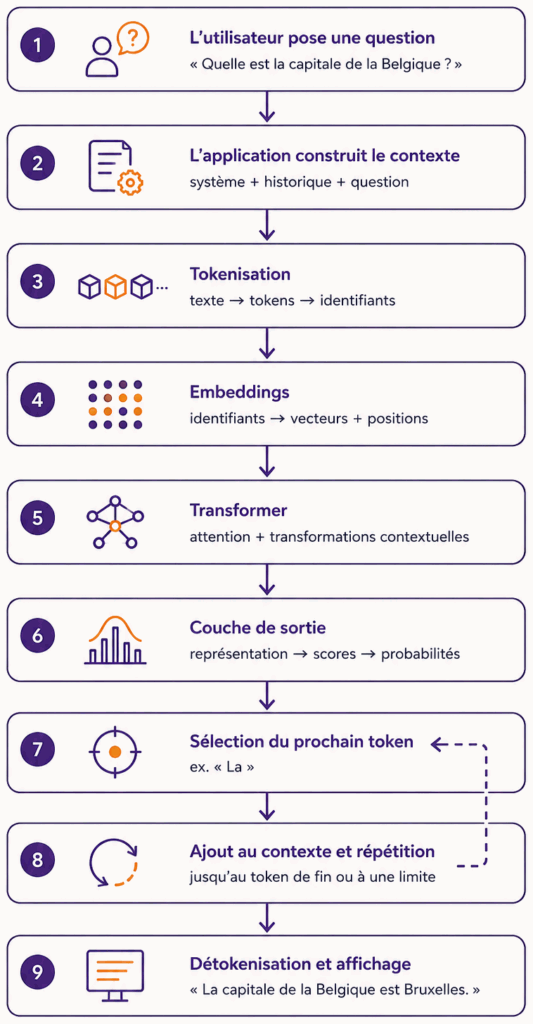
Le scénario de bout en bout
Reprenons le parcours complet, cette fois en indiquant à chaque étape qui l’exécute. C’est la distinction la plus utile à emporter de ce chapitre : la plupart des étapes appartiennent au modèle, mais l’application ouvre et referme le parcours.
- Utilisateur — écrit sa question et appuie sur Entrée.
- Application — assemble les instructions système, l’historique éventuel, le message de l’utilisateur et le marqueur indiquant que l’assistant doit répondre.
- Modèle — découpe ce contexte en tokens, puis en identifiants numériques.
- Modèle — convertit chaque identifiant en vecteur et y ajoute une information de position.
- Modèle — met les tokens en relation dans les couches du Transformer et construit une représentation contextuelle.
- Modèle — attribue un score à chaque token du vocabulaire, puis convertit ces scores en probabilités.
- Modèle — sélectionne le prochain token selon les paramètres de décodage.
- Modèle — ajoute ce token au contexte et recommence, jusqu’à produire un token de fin ou jusqu’à ce que l’application applique une règle d’arrêt.
- Application — détokenise la séquence et affiche la réponse.
Sur ces neuf étapes, sept relèvent du modèle et deux de l’application. Ce sont pourtant ces deux-là qui déterminent ce que le modèle reçoit et ce que l’utilisateur voit.
Schéma de synthèse
Au début de ce chapitre, notre modèle mental tenait en trois éléments : une question, une mystérieuse boîte noire appelée « IA » et une réponse. Nous pouvons maintenant reprendre ce même trajet, mais cette fois avec le capot ouvert.
La figure suivante rassemble les neuf étapes que nous avons découvertes, de la question initiale à la réponse affichée.
Erreurs fréquentes
Erreur 1 — « La tokenisation comprend la phrase »
Faux.
La tokenisation découpe le texte. La construction d’une représentation contextuelle se produit principalement dans le Transformer.
Erreur 2 — « Le LLM cherche la réponse dans une base vectorielle interne »
Faux dans le scénario simple.
Les connaissances apprises sont distribuées dans les paramètres du modèle. Une base vectorielle externe intervient uniquement si l’application ajoute un mécanisme comme le RAG.
Erreur 3 — « Le modèle génère d’abord toute la réponse dans sa tête »
Pas nécessairement.
Le mécanisme de base est autorégressif : le modèle prédit et sélectionne les tokens successivement.
Erreur 4 — « L’historique est mémorisé naturellement par le modèle »
Généralement faux.
L’application réinjecte tout ou partie de l’historique dans le contexte.
Erreur 5 — « Une réponse fluide est forcément vraie »
Faux.
Le modèle optimise la plausibilité de la continuation, pas une garantie absolue de vérité.
Une analogie utile, mais imparfaite
Un LLM peut être décrit comme un système d’autocomplétion extrêmement sophistiqué.
Un clavier de téléphone peut proposer :
Bonjour, comment...puis :
allez-vousUn LLM accomplit un mécanisme conceptuellement apparenté, mais avec :
- un contexte beaucoup plus long ;
- des milliards de paramètres ;
- des représentations sémantiques complexes ;
- des relations entre concepts ;
- une capacité à suivre des instructions ;
- une capacité à générer des structures élaborées.
L’analogie est utile pour comprendre la prédiction du prochain token.
Elle devient toutefois trompeuse si elle laisse croire que le modèle se contente de répéter des phrases exactes déjà vues. Il peut recombiner, généraliser et produire des réponses nouvelles.
Aller plus loin
Deux approfondissements complètent ce chapitre sans être nécessaires à la compréhension du fil principal :
- Comprendre les fichiers de modèles LLM distingue l’architecture, les poids, l’artefact distribué, le moteur d’inférence et les paramètres d’exécution ;
- Tokenisation, embeddings et représentations développe les nuances entre vecteurs internes au modèle, représentations contextualisées et embeddings documentaires.
Ces contenus peuvent être lus après le chapitre ou consultés ultérieurement comme références.
En résumé
Une explication simple pourrait être :
Lorsque je pose une question, l’application rassemble ma demande avec les instructions et l’historique utile. Ce texte est découpé en tokens, puis transformé en vecteurs numériques. Le Transformer analyse les relations entre ces tokens et construit une représentation contextuelle de la demande. À partir de cette représentation, le modèle calcule quel token devrait venir ensuite, en sélectionne un, l’ajoute au contexte et recommence. La réponse apparaît donc progressivement, jusqu’à ce que le modèle produise un token de fin ou qu’une limite externe arrête la génération.
LE MODÈLE MENTAL EN UNE PHRASE
Un LLM est un moteur qui transforme un contexte en probabilités sur le prochain token, puis répète cette opération jusqu’à produire une réponse complète.
Vérifiez votre compréhension
Question 1 — La tokenisation sert-elle à comprendre la signification de la question ?
Réponse : Non. Elle sert à découper le texte en unités manipulables par le modèle.
Question 2 — La réponse complète est-elle déjà présente au moment de la première tokenisation ?
Réponse : Non. Seul le contexte existant est tokenisé. La nouvelle réponse est ensuite générée token par token.
Question 3 — Où se trouve la connaissance selon laquelle Bruxelles est la capitale de la Belgique ?
Réponse : Elle est représentée de manière distribuée dans les paramètres appris par le modèle, et non nécessairement dans une table ou une base de données classique.
Question 4 — Quel composant construit principalement la représentation contextuelle de la question ?
Réponse : Le Transformer.
Question 5 — Le Transformer produit-il directement toute la phrase finale ?
Réponse : Il produit une représentation utilisée pour calculer les probabilités du prochain token. La phrase est ensuite générée progressivement.
Question 6 — Pourquoi le modèle ne répond-il pas toujours exactement de la même manière ?
Réponse : Plusieurs continuations peuvent être plausibles, et les paramètres de décodage peuvent introduire une part de variation.
Question 7 — Comment la génération se termine-t-elle ?
Réponse : Par un token de fin ou par une limite externe : nombre maximal de tokens, séquence d’arrêt, taille du contexte, interruption ou erreur.
Question 8 — ChatGPT et le LLM sont-ils la même chose ?
Réponse : Non. ChatGPT est une application complète qui utilise un ou plusieurs modèles et de nombreux composants autour d’eux.
Transition vers le chapitre suivant
Jusqu’à présent, tout ce que nous avons manipulé était du texte. Pourtant, dans le monde réel, les utilisateurs échangent aussi des images, des documents, de la voix et parfois même de la vidéo.
Stéphane pourrait envoyer la photo d’un vélo endommagé, dicter un message vocal ou joindre un document. Pour qu’un système d’IA puisse exploiter ces informations avec le langage, elles doivent d’abord être converties en représentations que le modèle peut traiter.
Le chapitre suivant élargit donc notre modèle mental :
Chapitre 2 — Que voit l’IA sur cette photo ?
Au-delà du texte : comment un modèle comprend-il différents types d’entrées ?
Nous verrons comment une solution d’IA transforme une image, un son, une vidéo ou un document en représentations que le modèle peut exploiter avec le langage