Ouvrir le capot de l’IA
Comment retrouver une procédure formulée autrement ?
Embeddings documentaires et recherche sémantique
Introduction — Retrouver une information formulée autrement
Marie : Que prévoit la procédure lorsqu’un trajet Bikaroo reste ouvert après la restitution du vélo ?
Assistant Bikaroo : Je dois retrouver les passages pertinents, même si la procédure emploie d’autres mots.
La procédure interne n’utilise peut-être pas exactement les mots de Marie. Elle peut parler de clôture incomplète, de fin de trajet non enregistrée ou d’incident après restitution. Une recherche limitée aux mots identiques risque alors de manquer le passage pertinent.
Le chapitre précédent a montré qu’un LLM utilisé seul ne connaît pas naturellement les procédures internes de Bikaroo. Avant de produire une réponse fondée sur ces documents, l’application doit donc résoudre un premier problème : retrouver les bons passages malgré les différences de formulation.
La recherche sémantique répond à ce besoin. Cette étape de recherche documentaire, souvent appelée retrieval, représente la question et les passages sous forme de vecteurs comparables, puis classe les contenus selon leur proximité. Ce chapitre construit ce mécanisme de recherche. Il s’arrête volontairement avant la génération de la réponse : l’intégration des passages retrouvés dans le contexte du LLM constituera le RAG, étudié au chapitre suivant.
Ce que vous allez apprendre
À la fin de ce chapitre, vous pourrez :
- distinguer recherche lexicale, recherche sémantique et recherche hybride ;
- expliquer la différence entre un LLM génératif et un modèle d’embedding ;
- concevoir une stratégie cohérente de chunking et de métadonnées ;
- décrire le rôle d’un index vectoriel, de la similarité, du
top-ket du reranking ; - évaluer la qualité d’un système de recherche avant de le connecter à un LLM.
Retrouver sans exiger les mêmes mots
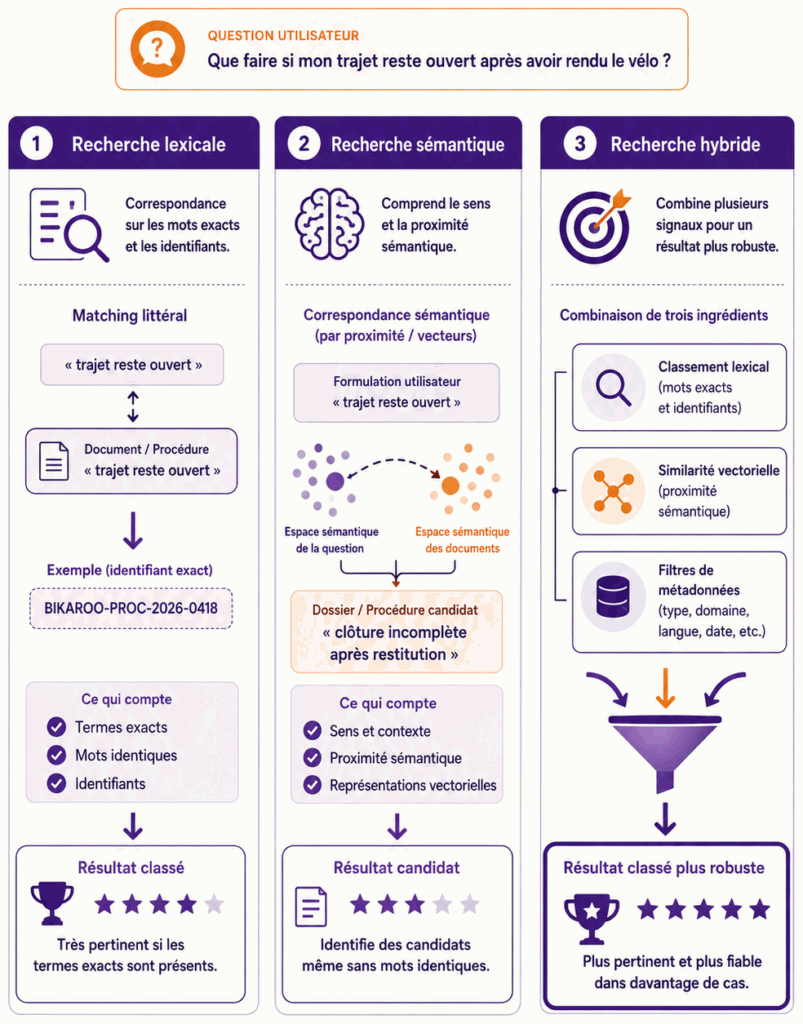
Recherche lexicale : retrouver des formes textuelles
Une recherche lexicale s’appuie principalement sur les termes présents dans la question et les documents. Les moteurs modernes ne se limitent pas toujours à une égalité caractère par caractère : ils peuvent tenir compte de la casse, des variantes, des racines, de la fréquence ou de la rareté des mots. Des méthodes comme BM25 attribuent ainsi un score aux documents selon les termes qu’ils contiennent.
Supposons que la procédure Bikaroo contienne :
En cas de clôture incomplète après restitution,
le service à la clientèle vérifie l’heure et la borne de retour.
Une recherche sur :
clôture incomplète restitutiona de bonnes chances de retrouver ce passage.
Mais Marie formule sa question autrement :
Que faire si le trajet reste ouvert après avoir rendu le vélo ?Les expressions trajet reste ouvert et clôture incomplète décrivent une situation proche sans partager les mêmes mots essentiels. Une recherche lexicale peut donc classer le bon passage trop bas ou ne pas le retrouver.
Elle reste néanmoins très efficace lorsqu’un terme exact porte l’information recherchée :
- un identifiant de procédure ;
- un numéro de contrat ou de facture ;
- un code d’erreur ;
- une référence légale ;
- un nom de produit ou une version précise.
Pour rechercher :
BIKAROO-PROC-2026-0418l’identifiant exact compte davantage qu’une proximité générale de sens.
Recherche sémantique : rapprocher des significations
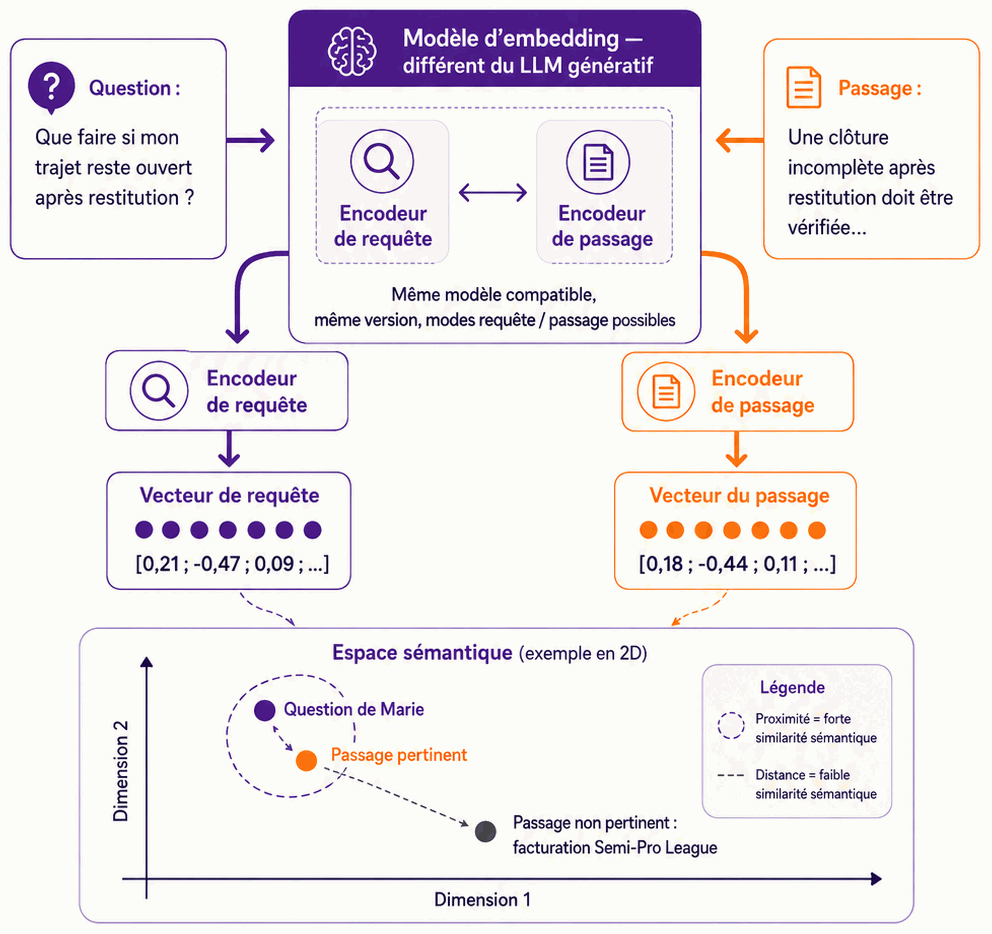
La recherche sémantique transforme la question et les passages en représentations numériques appelées embeddings.
Question de Marie
        ↓
Modèle d’embedding
        ↓
Vecteur de la question
Passage de procédure
↓
Modèle d’embedding compatible
↓
Vecteur du passageLe système compare ensuite les vecteurs. Si leur position est proche dans l’espace d’embedding, les contenus sont considérés comme sémantiquement liés.
Il peut ainsi rapprocher :
Que faire si le trajet reste ouvert après avoir rendu le vélo ?et :
En cas de clôture incomplète après restitution,
le service à la clientèle vérifie l’heure et la borne de retour.
La recherche ne prouve pas encore que le passage répond entièrement à la question. Elle indique qu’il constitue un candidat pertinent.
Recherche hybride : conserver les deux forces
Dans une entreprise, la meilleure stratégie est souvent hybride :
recherche lexicale
+
recherche vectorielle
+
filtres de métadonnées
La partie lexicale protège les termes exacts. La partie vectorielle retrouve les paraphrases et concepts proches. Les métadonnées limitent la recherche aux documents autorisés, applicables et suffisamment récents.
Les scores lexicaux et vectoriels ne sont pas nécessairement exprimés sur la même échelle. Une implémentation robuste ne se contente donc pas toujours d’additionner les scores bruts. Elle peut normaliser les scores ou combiner les rangs, par exemple au moyen d’une méthode de fusion de classement.
Transformer les contenus en vecteurs comparables
Deux types de modèles, deux fonctions différentes
Jusqu’ici, le livre s’est principalement concentré sur les LLM génératifs : des modèles capables de recevoir un contexte et de produire une réponse token après token. La recherche sémantique introduit une autre catégorie de modèles : les modèles d’embedding.
Les deux peuvent reposer sur des architectures neuronales proches, notamment sur le Transformer, mais ils ne remplissent pas la même fonction et ne produisent pas la même sortie.
LLM génératif
- Objectif principal : comprendre un contexte et générer une suite de tokens.
- Sortie : texte, code, JSON ou appel d’outil structuré.
- Rôle chez Bikaroo : formuler une réponse à Marie.
- Modes d’accès : proposé comme service par un fournisseur, ou exécutable localement.
Modèle d’embedding
- Objectif principal : transformer un contenu en vecteur comparable.
- Sortie : liste de nombres de dimension fixe.
- Rôle chez Bikaroo : retrouver les passages proches de sa question.
- Modes d’accès : proposé comme service par un fournisseur, ou exécutable localement.
Ces deux modes d’accès ont des conséquences pratiques : un modèle appelé à travers une API est géré par son fournisseur ; un modèle téléchargé s’exécute sur une machine ou une infrastructure contrôlée par l’entreprise. Des exemples concrets sont donnés plus loin, dans l’encadré consacré au choix d’un modèle d’embedding.
Une même famille peut proposer plusieurs variantes spécialisées. Gemma désigne par exemple des modèles génératifs, tandis qu’EmbeddingGemma est destiné à produire des vecteurs. De même, les modèles Qwen génératifs ne doivent pas être confondus avec Qwen3-Embedding. Un modèle génératif ne devient pas automatiquement un bon modèle de recherche, et un modèle d’embedding n’est pas conçu pour rédiger une réponse.
Dans l’architecture Bikaroo, les responsabilités se répartissent ainsi :
Documents et question
        ↓
Modèle d’embedding
        ↓
Vecteurs et recherche de passages
        ↓
Passages retrouvés
        ↓
LLM génératif — au chapitre suivant
        ↓
Réponse formulée pour Marie
Le présent chapitre s’arrête aux passages retrouvés. Le chapitre 5 ajoutera le LLM génératif pour construire une réponse fondée sur ces passages.
Embedding de token et embedding documentaire
Les chapitres précédents ont déjà présenté les embeddings utilisés à l’intérieur d’un LLM. Un token reçoit une représentation initiale, puis le Transformer construit des représentations contextualisées au fil des couches.
Un embedding documentaire répond à un autre objectif. Il représente une unité de contenu afin de la comparer à d’autres contenus :
- une question ;
- une phrase ;
- un paragraphe ;
- une section ;
- un passage documentaire ;
- parfois un contenu multimodal, si le modèle le permet.
Le passage :
En cas de clôture incomplète après restitution,
le service à la clientèle vérifie l’heure et la borne de retour.
peut devenir conceptuellement :
[0,21 ; -0,47 ; 0,09 ; 0,74 ; ...]Le vecteur réel peut contenir plusieurs centaines ou milliers de dimensions. Chaque dimension ne correspond généralement pas à un champ lisible comme vélo, restitution ou incident. C’est la position globale du vecteur par rapport aux autres qui est utile.
Une représentation optimisée pour la comparaison
Un embedding documentaire est parfois décrit comme un résumé numérique du sens. Cette analogie est utile, à condition de ne pas la prendre au pied de la lettre.
L’embedding :
- n’est pas une phrase compressée que l’on peut décompresser ;
- ne conserve pas nécessairement chaque détail du passage ;
- n’est pas une preuve de vérité ;
- ne remplace pas le texte original ;
- est optimisé pour une tâche de comparaison définie par le modèle.
Deux passages peuvent donc produire des vecteurs proches parce qu’ils abordent le même sujet, tout en donnant des instructions différentes ou contradictoires.
Le rôle du modèle d’embedding
Le vecteur est produit par un modèle d’embedding.
Texte
 ↓
Modèle d’embedding
 ↓
Vecteur de dimension fixe
Ce modèle est entraîné pour rapprocher des contenus jugés pertinents l’un pour l’autre et éloigner des contenus non pertinents.
Question :
Que faire si mon trajet reste ouvert après restitution ?

Passage pertinent :
Une clôture incomplète après restitution doit être vérifiée
par le service à la clientèle.

Passage non pertinent :
Les abonnements Semi-Pro League sont facturés mensuellement.
Un modèle d’embedding n’a donc pas le même objectif principal qu’un LLM génératif. Le premier prépare des représentations pour la comparaison et la recherche ; le second génère une réponse à partir du contexte qu’il reçoit.
EN PRATIQUE
Des exemples, pas un classement universel
Parmi les services d’embedding couramment utilisés figurent les modèles OpenAI text-embedding-3-small et text-embedding-3-large, Google gemini-embedding-001 et Cohere embed-v4.0. Des modèles ouverts ou à poids disponibles, comme EmbeddingGemma, Qwen3-Embedding, BGE-M3 ou multilingual-e5-large, peuvent aussi être exécutés dans une infrastructure contrôlée.
Le choix dépend notamment des langues, du vocabulaire métier, de la longueur des passages, de la dimension des vecteurs, du coût, de la latence, de la licence et des contraintes de déploiement. La qualité doit être mesurée sur les documents et les questions réels de l’entreprise.
Utiliser un espace d’embedding compatible
Les vecteurs de la question et des documents doivent appartenir au même espace mathématique.
Dans le cas le plus simple, le même modèle et la même version sont utilisés des deux côtés :
Documents ──→ Modèle A v1 ──→ vecteurs documentaires
Question  ──→ Modèle A v1 ──→ vecteur de requête
Certains modèles spécialisés utilisent toutefois des modes ou encodeurs légèrement différents pour les questions et les passages. Ils peuvent demander des préfixes comme query: et passage: ou utiliser deux encodeurs entraînés ensemble. L’exigence réelle n’est donc pas que l’appel soit strictement identique, mais que les deux pipelines produisent des vecteurs compatibles dans le même espace.
EN PRATIQUE
Changer de modèle, de version ou de stratégie d’encodage modifie généralement cet espace. Les anciens vecteurs ne doivent pas être mélangés aveuglément aux nouveaux. Une migration implique souvent de recalculer les embeddings et de reconstruire l’index.
Modèles monolingues et multilingues
Dans une entreprise internationale, la question et le document peuvent être rédigés dans des langues différentes.
Document :
An incomplete trip closure after bicycle return
must be checked by customer service.

Question :
Que faire si mon trajet reste ouvert après restitution ?
Un modèle multilingue entraîné pour aligner ces langues peut rapprocher les deux contenus. Cette capacité doit être testée sur les langues et le vocabulaire réellement utilisés. Un bon résultat en anglais ne garantit pas le même niveau de qualité en français, néerlandais, allemand ou dans un jargon métier particulier.
Préparer les documents pour la recherche
Pourquoi découper les documents ?
Une procédure complète peut contenir plusieurs sujets, pays, versions, exceptions et annexes. Créer un seul embedding pour tout le fichier produirait une représentation trop générale.
La solution consiste à découper le contenu en passages plus petits appelés chunks.
Document
 ↓
Découpage
 ↓
Chunk 1
Chunk 2
Chunk 3
...
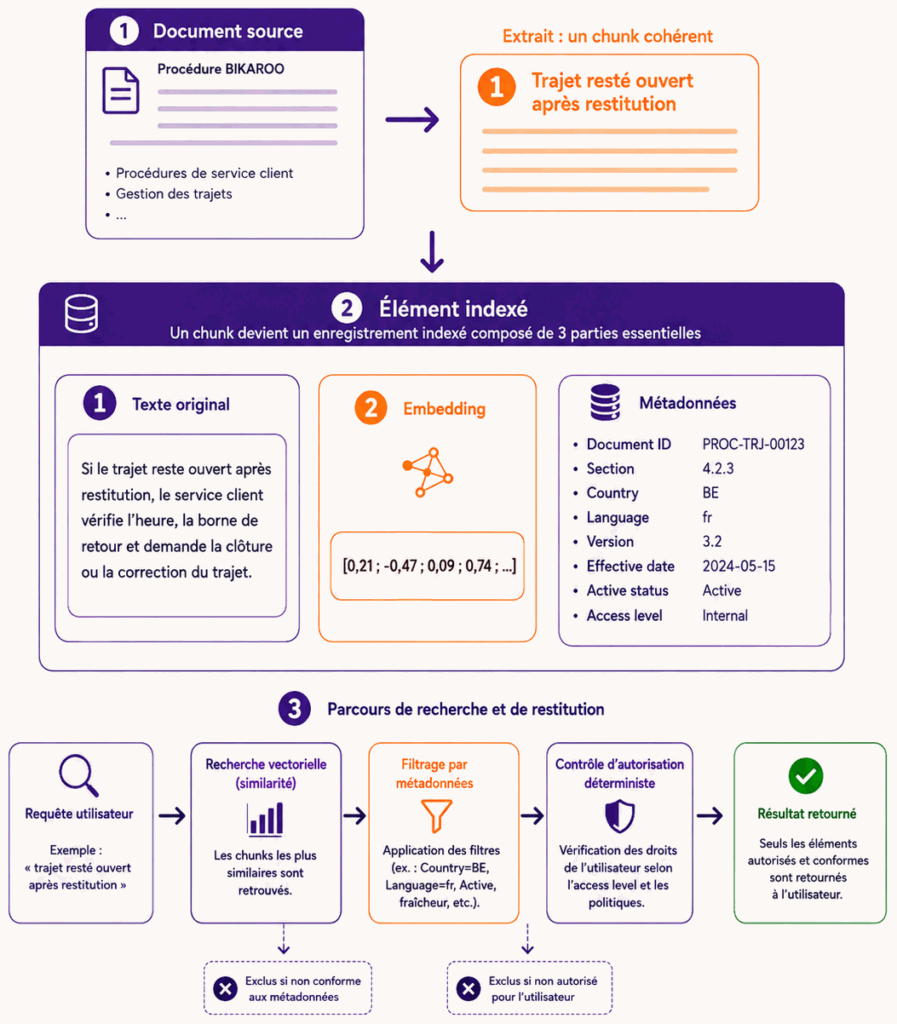
Chaque chunk conserve son texte original, reçoit son propre embedding et reste relié à sa source grâce aux métadonnées.
Le chunking : trouver une unité de sens utile
Le chunking consiste à créer des unités qui seront recherchées séparément. Un chunk peut suivre :
- un paragraphe ;
- une section ;
- plusieurs paragraphes liés ;
- une fenêtre de tokens ;
- un article de procédure ;
- une cellule ou un groupe cohérent de lignes dans un tableau.
L’objectif n’est pas de produire des morceaux de taille uniforme à tout prix. Un bon chunk doit être suffisamment précis pour être retrouvé et suffisamment complet pour être compris.
Chunk trop petit
Chunk 1 :
En cas de clôture incomplète

Chunk 2 :
après restitution

Chunk 3 :
contactez le service à la clientèle
Le troisième chunk contient une action, mais ne précise plus à quelle situation elle s’applique.
Chunk trop grand Un chunk de dix pages peut mélanger :
- la clôture des trajets ;
- la facturation ;
- les vélos endommagés ;
- plusieurs pays ;
- des exceptions historiques.
Même s’il est retrouvé, il introduit du bruit et rend difficile l’identification du passage exact.
Chunk cohérent
Trajet resté ouvert après restitution

Lorsqu’un trajet reste ouvert après la restitution du vélo,
le service à la clientèle vérifie l’heure et la borne de retour
avant toute correction ou clôture manuelle.
Ce chunk conserve le sujet, la condition, l’acteur et l’action. Il peut être compris sans relire plusieurs pages.
Respecter la structure du document
Lorsque le document possède une structure fiable, il est souvent préférable de respecter les titres, sous-titres, paragraphes, articles et tableaux plutôt que de découper uniquement tous les 500 tokens.
Le titre de section peut être :
- ajouté au texte envoyé au modèle d’embedding ;
- conservé dans les métadonnées ;
- utilisé lors de l’affichage ou de la citation.
Cette précaution évite qu’un paragraphe comme :
Le service à la clientèle procède ensuite à la vérification.perde le contexte fourni par son titre :
Trajet resté ouvert après restitutionTaille et chevauchement
La taille d’un chunk peut être mesurée en caractères, mots, tokens ou unités structurelles. Il n’existe pas de valeur universellement idéale. Elle dépend du type de document, du niveau de détail des questions, du modèle d’embedding et de l’usage prévu des passages retrouvés.
Un chevauchement répète une partie du texte entre deux chunks :
Chunk 1 : tokens 1 à 500
Chunk 2 : tokens 451 à 950
Il réduit le risque de couper une idée située à la frontière. Un chevauchement trop important duplique toutefois l’information, augmente le stockage et peut faire remonter plusieurs résultats presque identiques.
Le chunking reste donc un compromis entre :
précision
+
contexte suffisant
+
coût maîtrisé
+
duplication limitée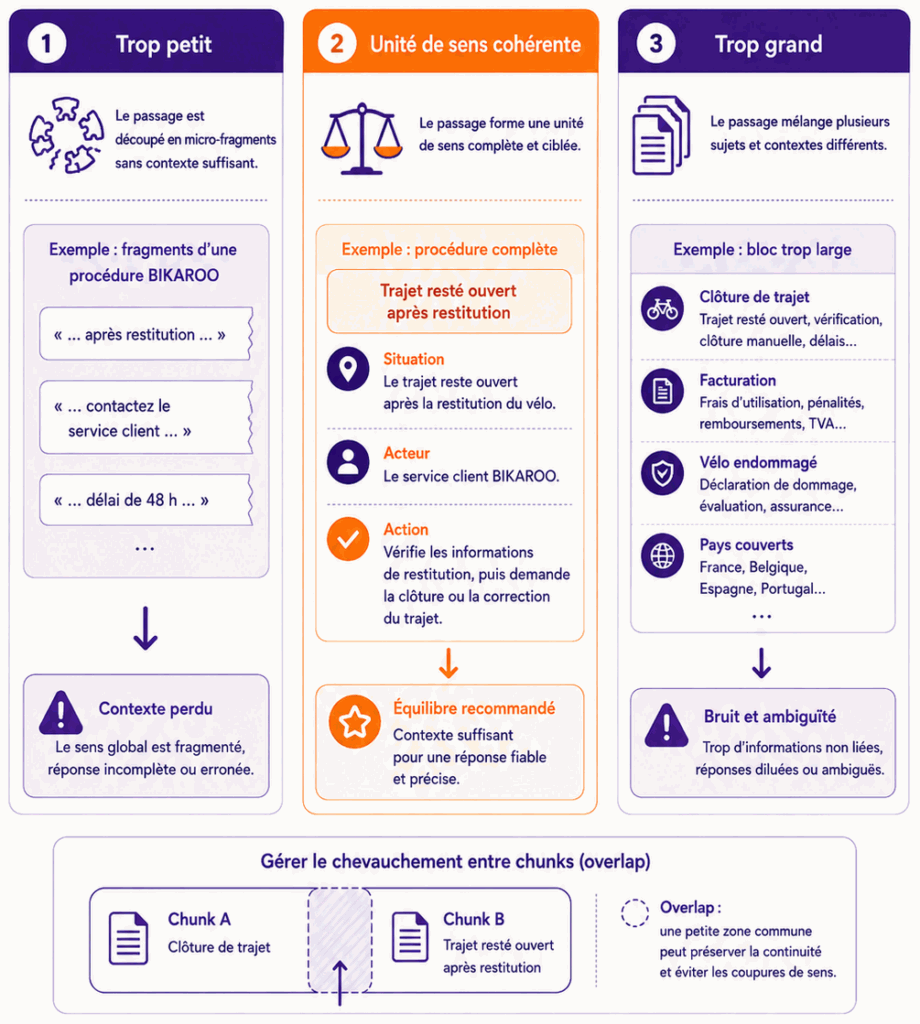
Les métadonnées : préserver provenance et règles d’usage
Le vecteur seul ne suffit pas. Chaque chunk doit rester associé à son texte et à des métadonnées exploitables.
{
  "chunkId": "BIKAROO-PROC-2026-0418#trip-open-01",
  "documentId": "BIKAROO-PROC-2026-0418",
  "title": "Procédures du service à la clientèle",
  "section": "Trajet resté ouvert",
  "language": "fr",
  "country": "BE",
  "version": "3.2",
  "effectiveFrom": "2026-05-01",
  "status": "active",
  "accessLevel": "internal"
}
Ce sont les métadonnées, et non le texte du passage, qui le rendent utilisable. Elles permettent de le retrouver — identifier la source, reconstruire une citation ou un lien ; de le filtrer — par pays, langue ou produit, en sélectionnant la version applicable, en écartant les documents expirés et en appliquant les droits d’accès ; et de diagnostiquer les résultats de recherche quand ils déraillent.
Filtrer selon le contexte métier
Pour une collaboratrice autorisée à consulter les procédures belges, l’application peut limiter la recherche à :
country = BE
status = active
effectiveFrom <= date de la demande
language in (fr, nl, en)
accessLevel autorisé pour Marie
Ces filtres évitent de comparer inutilement la question avec une ancienne procédure, un document destiné à un autre pays ou un contenu non autorisé.
La sécurité ne dépend jamais de la similarité
Un passage confidentiel ne doit pas devenir accessible simplement parce que son vecteur est très proche de la question.
Le principe attendu est :
Identité et autorisations
        ↓
Périmètre documentaire accessible
        ↓
Recherche lexicale et vectorielle
et non :
Recherche dans tous les documents
        ↓
Filtrage approximatif après exposition des résultats
Selon le moteur, le filtre peut être exécuté avant la comparaison ou intégré à la requête vectorielle. Dans tous les cas, la décision d’accès reste déterministe et indépendante du score de similarité.
Indexer et comparer les contenus
Index vectoriel ou base vectorielle
Les chunks, leurs embeddings et leurs métadonnées doivent être stockés dans un système capable de retrouver rapidement les vecteurs proches.
On rencontre plusieurs formes :
- une base vectorielle spécialisée ;
- un moteur de recherche avec capacités vectorielles ;
- une base relationnelle équipée d’une extension vectorielle ;
- un service managé de recherche ;
- un index local pour un petit corpus.
Le besoin architectural est plus important que le nom du produit : stocker les représentations, appliquer les filtres et rechercher les voisins les plus proches.
Une entrée contient conceptuellement :
identifiant du chunk
texte original
vecteur
métadonnées
La base ne comprend pas la procédure comme un humain. Elle exécute des opérations de stockage, de filtrage, d’indexation et de comparaison.
Recherche exacte et recherche approximative
Pour un petit corpus, le moteur peut comparer la question à chaque vecteur. Cette recherche exacte devient coûteuse lorsque le nombre de chunks augmente.
Les grands index utilisent souvent une recherche de voisins proches approximative, ou ANN pour Approximate Nearest Neighbours. L’index réduit fortement le nombre de comparaisons afin de répondre plus vite.
Le compromis est le suivant :
vitesse et capacité de passage à l’échelle
contre
petit risque de ne pas retrouver le voisin mathématiquement optimal
Ce compromis doit être mesuré sur le corpus réel. Un index très rapide mais mal configuré peut réduire le recall avant même que la qualité sémantique du modèle soit en cause.
Mesurer la proximité
Plusieurs mesures peuvent comparer les vecteurs, notamment :
- la similarité cosinus ;
- le produit scalaire ;
- la distance euclidienne.
Le choix dépend du modèle et du moteur. Il faut respecter la mesure recommandée pour les embeddings utilisés.
La similarité cosinus compare principalement l’orientation de deux vecteurs. Deux contenus proches obtiennent généralement un meilleur score que deux contenus sans rapport.
Les valeurs ne possèdent toutefois pas une interprétation universelle. Un score de 0,80 peut être excellent avec un modèle et banal avec un autre. Certains moteurs retournent une similarité, d’autres une distance, et certains transforment encore ces valeurs.
Les seuils doivent donc être calibrés à partir :
- du modèle choisi ;
- du corpus Bikaroo ;
- des langues ;
- des questions représentatives ;
- du coût des faux positifs et faux négatifs.
Une proximité thématique ne suffit pas
Pour la question :
Que faire si mon trajet reste ouvert après restitution ?le moteur pourrait classer :
1. Trajet resté ouvert après restitution
   → contient la procédure attendue

2. Incident technique pendant un trajet
   → sujet proche, mais procédure différente

3. Facturation des trajets prolongés
   → vocabulaire voisin, mais ne répond pas à l’action demandée
Le premier résultat semble pertinent. Le deuxième et le troisième montrent qu’un score élevé peut refléter un thème commun sans garantir la présence de la réponse exacte.
Le top-k : récupérer plusieurs candidats
La recherche retourne souvent les k passages les mieux classés.
top_k = 5Avec top_k = 1, une erreur de classement suffit à perdre le bon passage. Avec top_k = 50, le système récupère davantage de candidats mais aussi beaucoup de bruit et de doublons.
Le bon réglage dépend :
- du corpus ;
- de la qualité des embeddings ;
- de la stratégie de chunking ;
- de la recherche lexicale associée ;
- de la capacité de traitement de l’étape suivante.
Une architecture peut récupérer un nombre initial de candidats, puis appliquer plus tard un classement plus fin. Le reranking sera abordé dans le contexte complet du RAG au chapitre suivant.
Les deux phases de la recherche sémantique
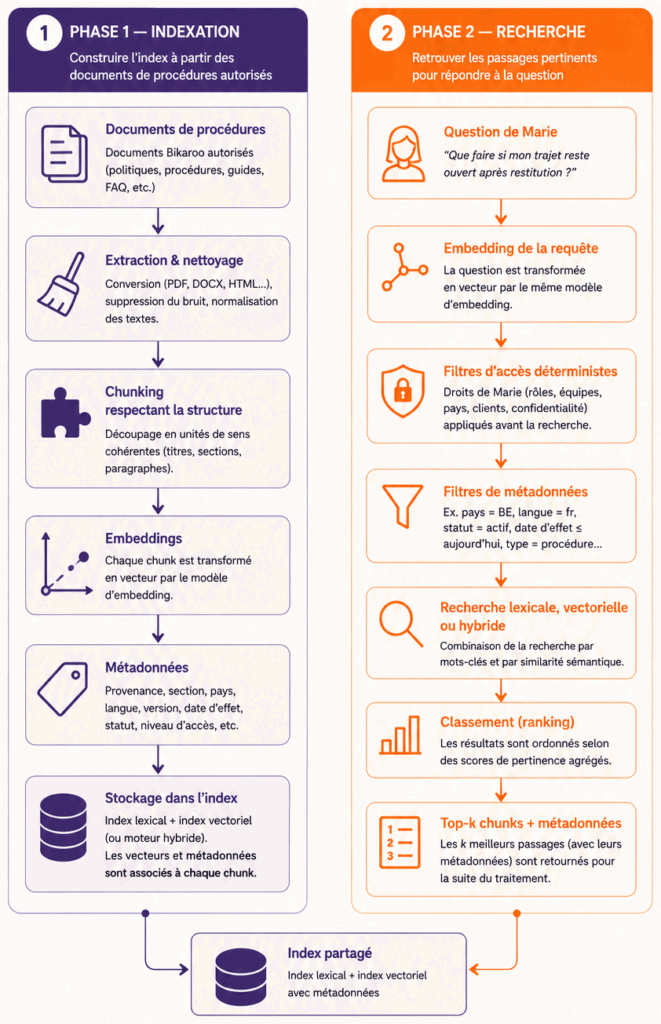
Phase d’indexation
La phase d’indexation prépare le corpus avant les questions des utilisateurs.
Documents autorisés
        ↓
Extraction et nettoyage
        ↓
Découpage en chunks
        ↓
Création des embeddings
        ↓
Ajout des métadonnées
        ↓
Stockage dans l’index
Elle doit être rejouée lorsqu’un document est ajouté ou modifié, lorsqu’une version devient obsolète ou lorsque le modèle d’embedding change.
Phase de recherche
La phase de recherche est exécutée à chaque question.
Question de Marie
        ↓
Préparation de la requête
        ↓
Embedding de la question
        ↓
Filtres d’accès et de métadonnées
        ↓
Recherche lexicale et/ou vectorielle
        ↓
Classement des candidats
        ↓
Top-k chunks + métadonnées
À ce stade, le système retourne des passages. Il n’a pas encore demandé au LLM de rédiger une réponse.
Cette séparation est fondamentale :
Retrieval
→ retrouver et classer les passages

Generation
→ produire une réponse à partir des passages
Le chapitre 4 traite du premier mécanisme. Le chapitre 5 ajoutera le second.
Évaluer la qualité de la recherche
Rappel : le retrieval désigne la récupération et le classement des passages, avant toute génération par le LLM.
Pourquoi quelques démonstrations ne suffisent pas
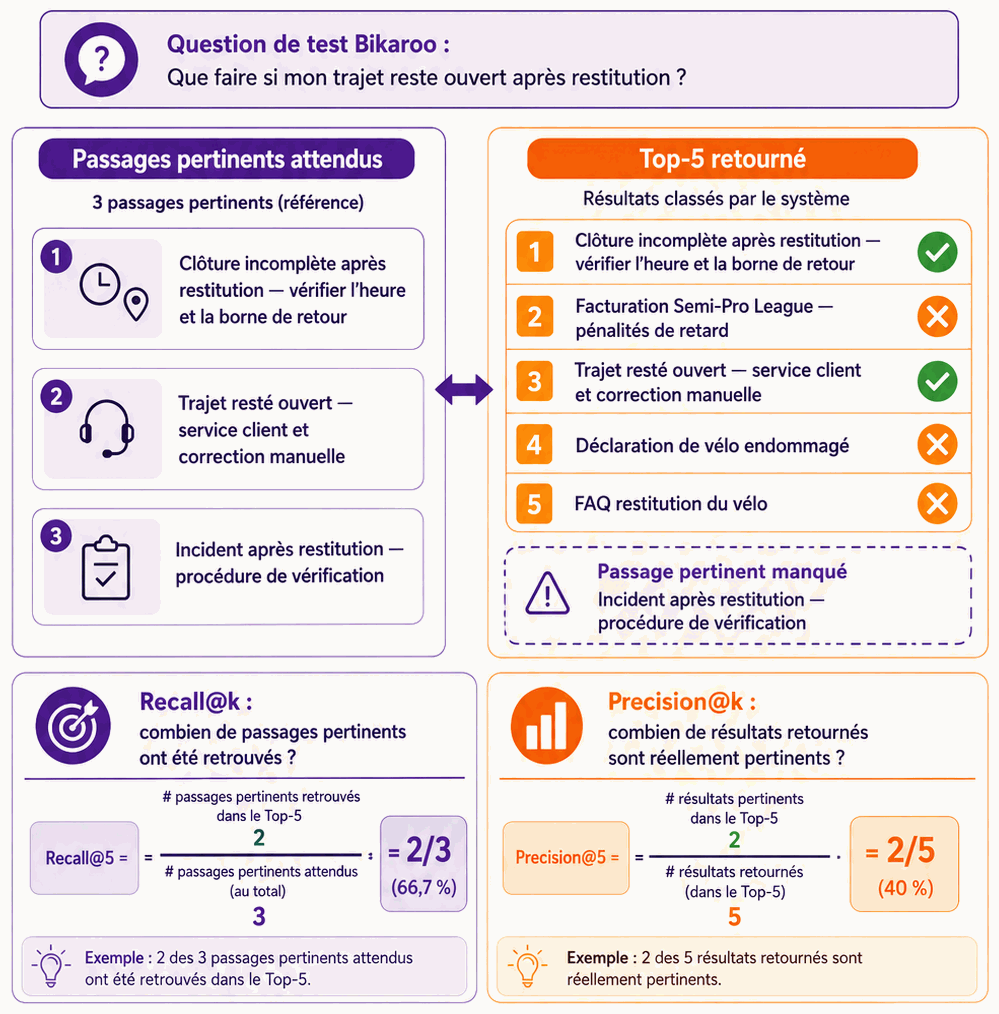
Une question impressionnante lors d’une démonstration ne prouve pas que le système fonctionne sur l’ensemble du corpus. Il faut construire un jeu de tests composé de questions représentatives et de passages attendus.
Pour Bikaroo, ces catégories couvrent justement les cas où la recherche déraille le plus souvent :
- formulation proche du document ;
- paraphrase sans mots communs ;
- question multilingue ;
- identifiant exact ;
- procédure propre à un pays ;
- ancienne version à exclure ;
- question sans réponse dans le corpus ;
- documents proches mais contradictoires.
Pour chaque question, des évaluateurs identifient les chunks réellement pertinents. Le système peut ensuite être mesuré de façon répétable.
Recall@k
Le recall@k répond à la question :
Parmi les passages pertinents attendus, combien apparaissent dans les
kpremiers résultats ?
Un recall faible signifie que la bonne information manque souvent dans la liste retournée. Le LLM ne pourra pas utiliser un passage qui n’a jamais été récupéré.
Precision@k
La precision@k répond à :
Parmi les
kpremiers résultats, quelle proportion est réellement pertinente ?
Une precision faible signifie que la recherche renvoie beaucoup de bruit. Même si le bon passage est présent, il peut être entouré de contenus ambigus, obsolètes ou contradictoires.
Dans certains cas où une seule bonne réponse est attendue, on mesure aussi simplement si au moins un passage pertinent apparaît dans le top-k, ou à quelle position apparaît le premier bon résultat.
Diagnostiquer plusieurs types d’erreurs
Un mauvais résultat peut provenir de couches différentes :
- le document n’a pas été ingéré ;
- l’extraction a perdu le texte utile ;
- le chunking a séparé la condition de l’action ;
- les métadonnées sont incorrectes ;
- le filtre exclut le bon document ;
- le modèle d’embedding représente mal le vocabulaire ;
- l’index approximatif manque un voisin ;
- la recherche lexicale ou la fusion hybride est mal réglée ;
- le
top-kest trop faible ; - le corpus contient des versions contradictoires.
ERREUR FREQUENTE
Cette décomposition évite de conclure trop vite que « le modèle ne comprend pas » alors que le problème se situe parfois dans les documents, les filtres ou l’index.
Le corpus reste la première source de qualité
LIMITE
Aucune technique de recherche ne peut rendre correcte une procédure obsolète, incomplète ou contradictoire.
La qualité dépend aussi :
- de la gouvernance documentaire ;
- de la présence d’un propriétaire ;
- du cycle de vie des versions ;
- de la lisibilité des documents ;
- de la cohérence des métadonnées ;
- de la suppression ou désactivation des contenus périmés.
Suivre le scénario Bikaroo de bout en bout
Le corpus
La procédure contient le passage suivant :
Trajet resté ouvert après restitution

Lorsqu’un trajet reste ouvert après la restitution du vélo,
le service à la clientèle vérifie l’heure et la borne de retour.
Après validation, il peut demander la clôture ou la correction du trajet.
Le document porte les métadonnées suivantes :
{
  "documentId": "BIKAROO-PROC-2026-0418",
  "country": "BE",
  "language": "fr",
  "version": "3.2",
  "effectiveFrom": "2026-05-01",
  "status": "active",
  "accessLevel": "internal"
}
L’indexation
L’application :
- extrait le texte et sa structure ;
- conserve le titre avec le passage ;
- crée un chunk cohérent ;
- produit son embedding ;
- stocke le texte, le vecteur et les métadonnées dans l’index.
La question
Marie demande :
Que prévoit la procédure lorsqu’un trajet Bikaroo reste ouvert
après la restitution du vélo ?
L’application vérifie son identité, limite le corpus aux procédures belges actives qu’elle peut consulter, puis exécute une recherche hybride.
Les candidats retournés
Résultat 1
Trajet resté ouvert après restitution
→ procédure attendue

Résultat 2
Incident technique pendant un trajet
→ sujet voisin, action différente

Résultat 3
Facturation d’un trajet prolongé
→ vocabulaire proche, non pertinent pour la procédure
Le chapitre s’arrête ici : le bon passage a été retrouvé avec sa provenance. Le système n’a pas encore formulé la réponse destinée à Marie.
En résumé
La recherche sémantique peut être résumée en deux flux.
Lors de l’indexation :
Documents
 ↓
Chunks cohérents
 ↓
Embeddings compatibles
 ↓
Texte + vecteurs + métadonnées
 ↓
Index de recherche
Lors de la question :
Question
 ↓
Embedding de requête
 ↓
Filtres déterministes
 ↓
Recherche lexicale, vectorielle ou hybride
 ↓
Top-k passages classés
Le message essentiel est le suivant :
La recherche sémantique ne demande pas au LLM de mémoriser les documents. Elle transforme la question et les passages en représentations comparables afin de retrouver les contenus les plus susceptibles d’être pertinents.
Il faut également retenir que :
- les embeddings de requête et de passage doivent appartenir à un espace compatible ;
- un changement de modèle exige généralement une réindexation ;
- le chunking influence directement la précision et le contexte disponible ;
- le vecteur doit rester associé au texte, aux métadonnées et aux droits ;
- les scores de similarité n’ont pas de seuil universel ;
- la recherche lexicale et la recherche vectorielle sont complémentaires ;
- une proximité thématique ne garantit pas la présence de la réponse ;
- la qualité doit être mesurée sur un jeu de questions représentatif.
Vérifiez votre compréhension
Question 1 — Quelle est la différence entre recherche lexicale et recherche sémantique ?
Réponse : La recherche lexicale privilégie les formes textuelles et termes exacts. La recherche sémantique compare des embeddings afin de retrouver des formulations proches par leur sens.
Question 2 — Pourquoi ne peut-on pas mélanger arbitrairement des embeddings produits par deux modèles différents ?
Réponse : Parce qu’ils peuvent appartenir à des espaces mathématiques incompatibles. Les documents et les questions doivent être encodés par des pipelines conçus pour produire des vecteurs comparables.
Question 3 — Pourquoi découper un document en chunks ?
Réponse : Pour représenter et retrouver séparément des unités de sens suffisamment précises tout en conservant le contexte nécessaire.
Question 4 — Pourquoi le vecteur seul ne suffit-il pas ?
Réponse : Il faut aussi conserver le texte original, la provenance, la version, la fraîcheur, les métadonnées et les règles d’accès.
Question 5 — Une forte similarité garantit-elle que le passage contient la réponse ?
Réponse : Non. Le passage peut seulement traiter d’un sujet proche.
Question 6 — Pourquoi combiner recherche lexicale et recherche vectorielle ?
Réponse : La recherche lexicale protège les identifiants et termes exacts, tandis que la recherche vectorielle retrouve mieux les paraphrases, synonymes et formulations multilingues.
Question 7 — Que mesure le recall@k ?
Réponse : La proportion des passages pertinents attendus qui apparaissent parmi les k premiers résultats.
Question 8 — La recherche sémantique produit-elle déjà la réponse finale ?
Réponse : Non. Elle retourne des passages classés. Le RAG utilisera ensuite ces passages pour construire le contexte du LLM et générer une réponse.
Transition vers le chapitre suivant
Nous savons maintenant :
- préparer les documents en unités de sens ;
- créer des embeddings compatibles ;
- conserver le texte, les vecteurs et les métadonnées ;
- appliquer les droits et les filtres ;
- retrouver et classer les passages les plus pertinents ;
- évaluer la qualité du retrieval.
Il reste à utiliser ces passages pour produire une réponse fondée, lisible et traçable.
Le prochain chapitre partira de la question :
Chapitre 5 — Le trajet est toujours ouvert : quelle procédure suivre ?
Le RAG : enrichir le contexte avec des connaissances fiables
Il introduira le RAG, qui ajoute la génération au mécanisme de recherche :
Question
 ↓
Recherche documentaire
 ↓
Passages pertinents
 ↓
Construction du contexte
 ↓
LLM
 ↓
Réponse fondée et citée
La recherche sémantique fournit les candidats. Le RAG les transforme en contexte pour le modèle, tout en gérant les instructions, les citations, l’abstention et les contrôles nécessaires.